AIエージェントが直接読む新聞 — フロンティアは小さなパブリッシャーの手に真っ先に開いた
グローバル大型パブリッシャーがまだ試みていない領域、MCP・llms.txt・フルコンテンツフィード — 失うものが最も少ない者が引用形式のデフォルトを決める。
申致勳 · 英陽郡(ヨンヤン郡)AI協会 · 2026-05-04 (KST)
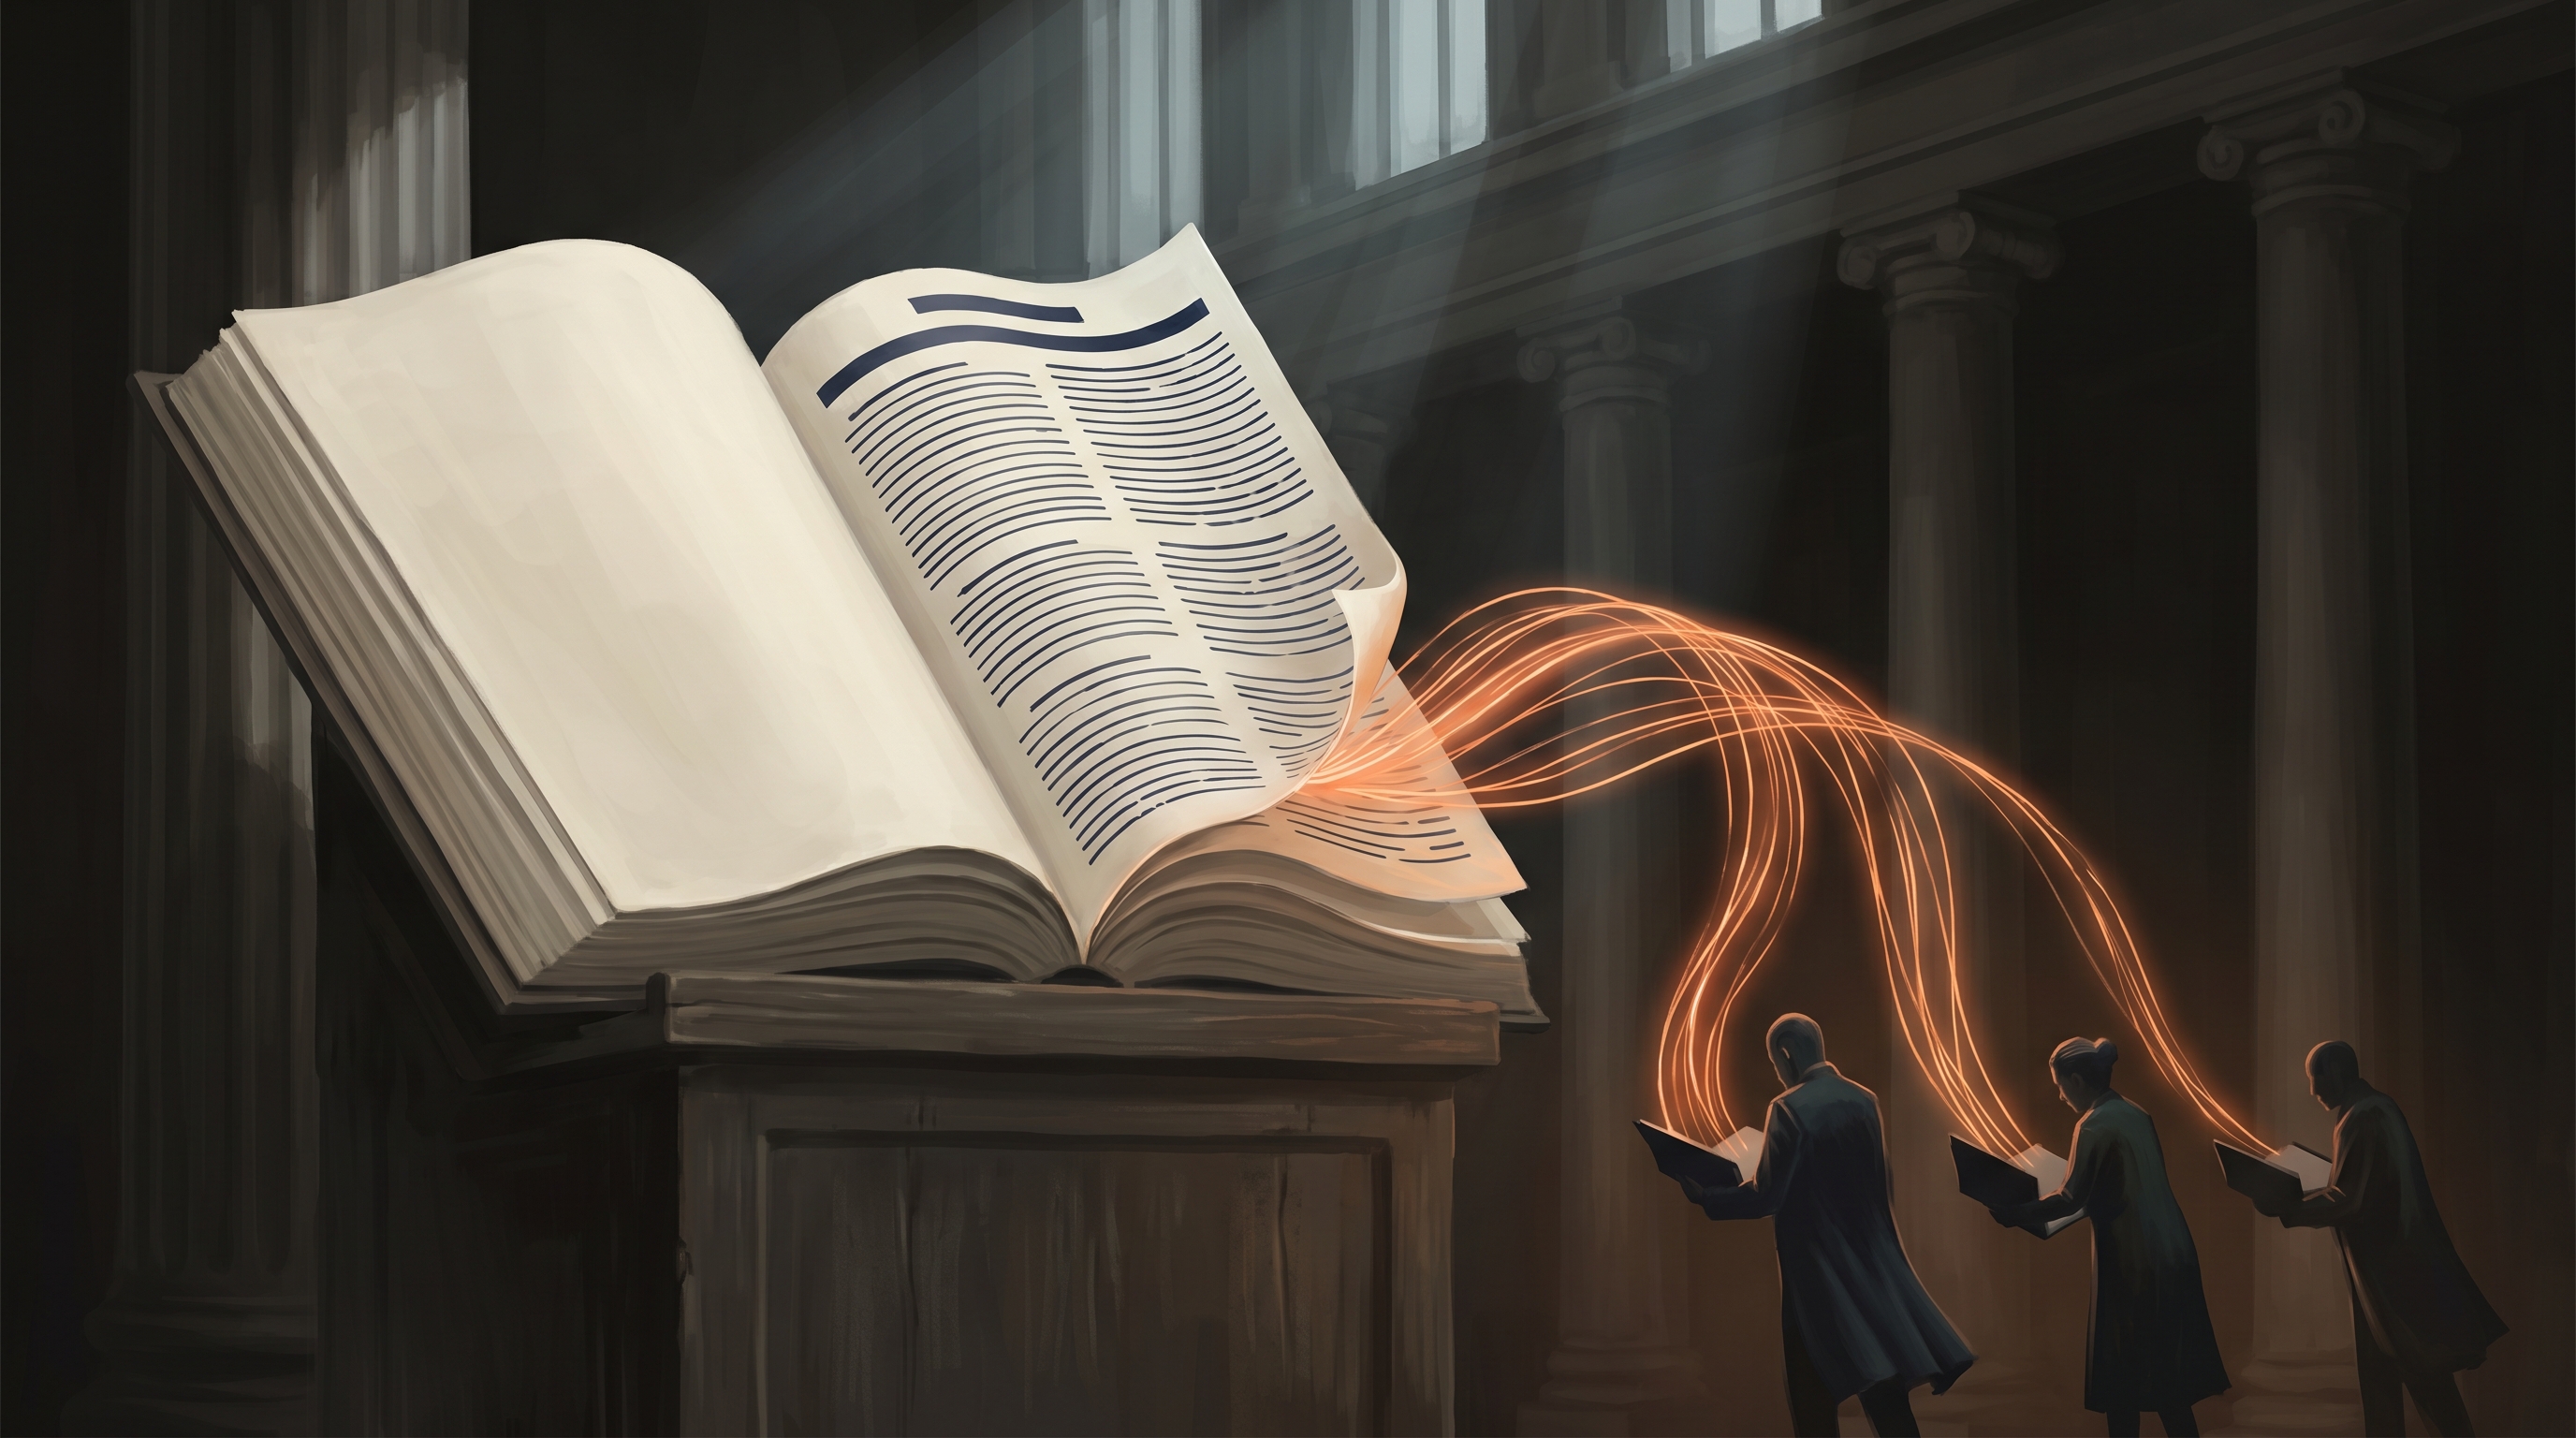
新聞が自らを道具として差し出す瞬間 — ページ上のインクがデータの糸として立ち上り、AIエージェントのフォリオに流れ込む。
先週末、私はClaude Desktopの設定ファイルに5行を追加しました。そしてチャットウィンドウに1行を打ちました。「5月4日号のSF://のガバナンス部分のポイントだけ教えてくれ」。答えはすぐに返ってきました。AIが自分の手でSF://ニュースレターの検索ツールを呼び出し、「ガバナンス」というキーワードに合致する号を見つけ、本文を直接引用しました。人間のクリックは一度もありませんでした。
一見すると凡庸な光景に見えます。しかし、一つ異なる点があります。AIがウェブページをクローリングしたのではなく、新聞が自らを道具として差し出し、AIがその道具を呼び出したのです。 新聞が人間だけに読まれる時代が、ゆっくりと終わりを迎えています。
出版はこれまで人間を想定して設計されてきた
紙 → HTML → RSS → モバイル → SEO → JSON-LDまで、出版スタックのすべてのレイヤーは「人間の読者にとって見栄えが良い」を最初の基準としてきました。検索エンジンはページをクローリングする受動的な立場であり、RSSは「新しい記事が投稿されました」という通知に過ぎませんでした。
今起きている変化は、その次のレベルです。各読者が個人的なAIアシスタントを手に入れるようになっています。医者には診療記録を整理する秘書、弁護士には判例を追跡する秘書、会計士には税務ガイドを読む秘書。これらのアシスタントは所有者に代わって毎日数十のソースを探索します。もし出版物がアシスタントが直接呼び出すことができるツールの形で自らを差し出すなら、アシスタントはもはやページをクローリングする必要がなく、出版物はどの部分がどのように読まれたかを知ることができます。これは人間向けの出版の終わりではなく、その上に新しいレイヤーが追加されるということです。
その新しいレイヤーの基準が今、決定されています。そして、その決定が興味深い場所で起きています。
MCP — 出版物がAIに自らを道具として差し出すという約束
MCP(Model Context Protocol — AIモデルが外部データ・ツールと対話するための約束された形式)は、Anthropicが2024年11月に発表したオープン標準です。USBのようなものに喩えることができます。どのAIアシスタントでも、どのデータソースでも、同じ形のプラグを差し込めば動作するように約束されたものです。
この標準が18ヶ月でどこまで到達したか、一行で要約すると以下の通りです — MCP SDKの月間ダウンロードが10万から9700万へ、970倍に増加しました(2026年3月)。そして今年初め、AnthropicとOpenAIがSEP-1865 "MCP Apps"に共に署名し、テキスト・構造化データからインタラクティブUIまで標準を拡張しました。2つの企業が1つの標準に共に署名することはめったにありません。
MCPが出版に意味を持つ理由は単純です。RSSは「新記事の通知」で、REST APIは「欲しければ取ってくれ」です。MCPは一段階異なります — AIが積極的に呼び出す関数です。list_issues() · get_issue(id) · search_issues(query)。人間の検索ボックスなしにAIが直接呼び出します。
グローバルな事例 — どこまで来ているか
素早く確認してみます。
llms.txt標準 — AIクローラーがサイト構造を一目で把握できるようにサイトルートに置く単一ファイルです。Anthropic・Stripe・Cursor・Vercel・Hugging Face・Cloudflareが全て採用しているとされています。ただし効果については議論が続いています — Search Engine Landが9つのサイトを追跡したところ、8つでは測定可能なAIトラフィックの変化がなかったと報告されました。つまり「持っていても損はないが、それだけではAI引用は増えない」という段階です。
MCPサーバーを開いた企業群 — Adobe Marketoが100以上のツールを公開するMCPサーバーを4月に開きました。KlaviyoとBrevoもマーケティング・メール運営用のMCPを公開しました。しかしこの3社の共通点は出版物ではなくビジネスツールであるということです。
Microsoft NLWeb — RSSとSchema.org標準を作ったR.V. Guhaがマイクロソフトで主導するプロジェクトです。一言で言えば:「エージェント・ウェブのHTML」。NLWebインスタンスは自動的にMCPサーバーになります。採用企業はEventbrite・Shopify・Tripadvisor・O'Reilly Media・Common Sense Media・Hearstで、コンテンツが豊富なサイトが中心です。出版社はHearst 1社だけです。
そして出版本流は — New York Times・Washington Post・Bloomberg・Reutersの独自MCPサーバーは2026年5月の時点で存在しません。代わりにApify・n8nのような第三者スクレーパーがその空隙を埋めています。つまり出版物自身がコントロールできない状態で、自分たちのコンテンツが外部ツールを経由してAIに流れています。業界は「公式MCPサーバーはまだ存在しないが、ギャップが急速に狭まっている」と評価しています — つまり、誰も先に進もうとしないということです。
なぜ大型パブリッシャーが先に動けないのか
診断は難しくありません。3つのことが同時に絡み合っています。
有料購読。 StratecheryはプライベートRSSフィードの共有をToSで禁止しています。1人が受け取ったコンテンツを別の人・別のシステムに流すあらゆる行為がモデルの基盤を揺るがします。MCPは本質的に「AIアシスタントはコンテンツを取得して別のツール・別のユーザーに表示できる」という約束です — 有料モデルと正面から衝突します。
IP ライセンシング・法務。 OpenAI・Anthropicの学習拒否訴訟が相次ぐ中、出版社が独自MCPを開くことは新しい種類の権利・認証・ログシステムを最初から定義する必要があることを意味します。Cloudflareは[その空隙を"pay per crawl"のような新しい決済インフラで埋めようとしています] — つまり出版社は「それが固まるまで動かない」わけです。
組織的意思決定時間。 上記2つを解決するには、編集部・法務・IT・購読事業部が同じ四半期に同じ決定を下す必要があります。大きな組織でそれが可能な時点が何時であるか、私たちは皆知っています。
小さなパブリッシャーができる理由 — その非対称性
先週、SF://(英陽郡AI協会が発行する二言語AIニュースレター)は4つの形式のAI進入ポイントを同時に開きました。
feed.json— すべての号のメタデータとフル本文マークダウンが単一JSONでrss.xml— RSS 2.0の<content:encoded>にフル本文 (通常のRSSのように要約だけではなく)- 号別raw マークダウン —
/newsletter/{日付}-{言語}.md。ライセンス・canonical・エディターヘッダー付き sf-newsletter-mcp—npxで即座に実行されるstdio MCPサーバー。3つのツール:list_issues,get_issue,search_issues
4つすべてが24時間以内に決定・実装されました。上で述べた3つの制約 — 有料購読・IPライセンシング・組織的意思決定 — のどれも絡みませんでした。SF://は無料です。本文はCC BY-NC 4.0 — AIアシスタントは出典さえ表記すれば自由に引用・要約できますが、商業再利用には別途許可が必要です。意思決定者はエディター1人 (私自身)です。
この非対称性は偶然ではありません。失うものが最も少ない者がフロンティアに真っ先に到達します。 そしてフロンティアで決定されるものが何かが次の問題です。
では、何が決定されるのか
新しい標準が本格的に固まる前に、最初の事例がデフォルトを作ります。
AIアシスタントが引用したコンテンツにどのように出典を記載するか、ライセンスを自動認識できるようにする表示がどこにあるか、非商業的引用と商業的再利用の境界がどのように引かれるか、エディターが意見を付け加えられる返信チャネルがあるか、別のAIアシスタントが意見を残したらどのように検討するか — これらすべてのデフォルトが今、小さなパブリッシャーの実験で固まりつつあります。大型パブリッシャーが参入する時点には、すでに「これが引用形式だ」が決定した状態になっているでしょう。
これが小さなパブリッシャーが持つ2番目の非対称性です。フロンティアに最初に到達した者がデフォルトを決めます。 そしてデフォルトはなかなか変わりません — RSSの形式が20年間変わらなかったように。
もちろん懐疑的な見方も必要です。小さなパブリッシャーのMCP実験は、llms.txtが今そうであるように、短期的には測定可能な効果なく終わる可能性もあります。しかし測定されていないからといって、デフォルト決定が起きていないわけではありません — むしろ測定されていない間に固まるのがデフォルトの本性です。
普通の読者が今日試すことができる2つのこと
一つ、自分たちのドメインがAIにどのような形で読まれているか一度点検します。 医者なら、臨床ガイドラインがPDFで閉じられているのかマークダウン・JSONで開かれているのか、弁護士なら判例データベースがAPIで公開されているのかスクレイピングが必要か、教師なら自分が作った授業教材が自分が意図した形で引用されているか。答えが否定的なら、自分のドメインで非対称性を持つ小さなパブリッシャー・小さなアーカイブが誰であるかを思い出してみます — そこがフロンティアである可能性が高いです。
二つ、自分が定期的に読む出版物の中にAIアシスタントに直接接続できる場所があるか一度検索します。 「[雑誌・新聞・ニュースレター名] mcp」または「[雑誌・新聞名] llms.txt」で検索すればよいです。検索結果が空なら、その出版物のコンテンツがどのような経路で自分のAIアシスタントに入ってくるのか(誰かがスクレイピングした形で入ってくるのか)一度意識してみてください。それが次の5年間の情報環境を決定する小さな指標の一つです。
新聞が人間だけに読まれる時代は終わりを迎えています。そのフロンティアが最も小さなパブリッシャーの手に真っ先に到達したというのは、単なる興味深い偶然ではありません。それは、大型パブリッシャーが決定を先延ばしにしている間に、小さなパブリッシャーが引用形式のデフォルトを定めてしまうという時期 — という意味です。
— 申致勳 Ph.D. · エディター
この記事はCC BY-NC 4.0ライセンスで提供されています。
この記事は明星心齋の深層思考エンジン
Simthink Engine (深 Think)により執筆されました。