「あなたは医者です」では足りない — 専門家プロンプトの正体
2026-04-28 · 申致勳
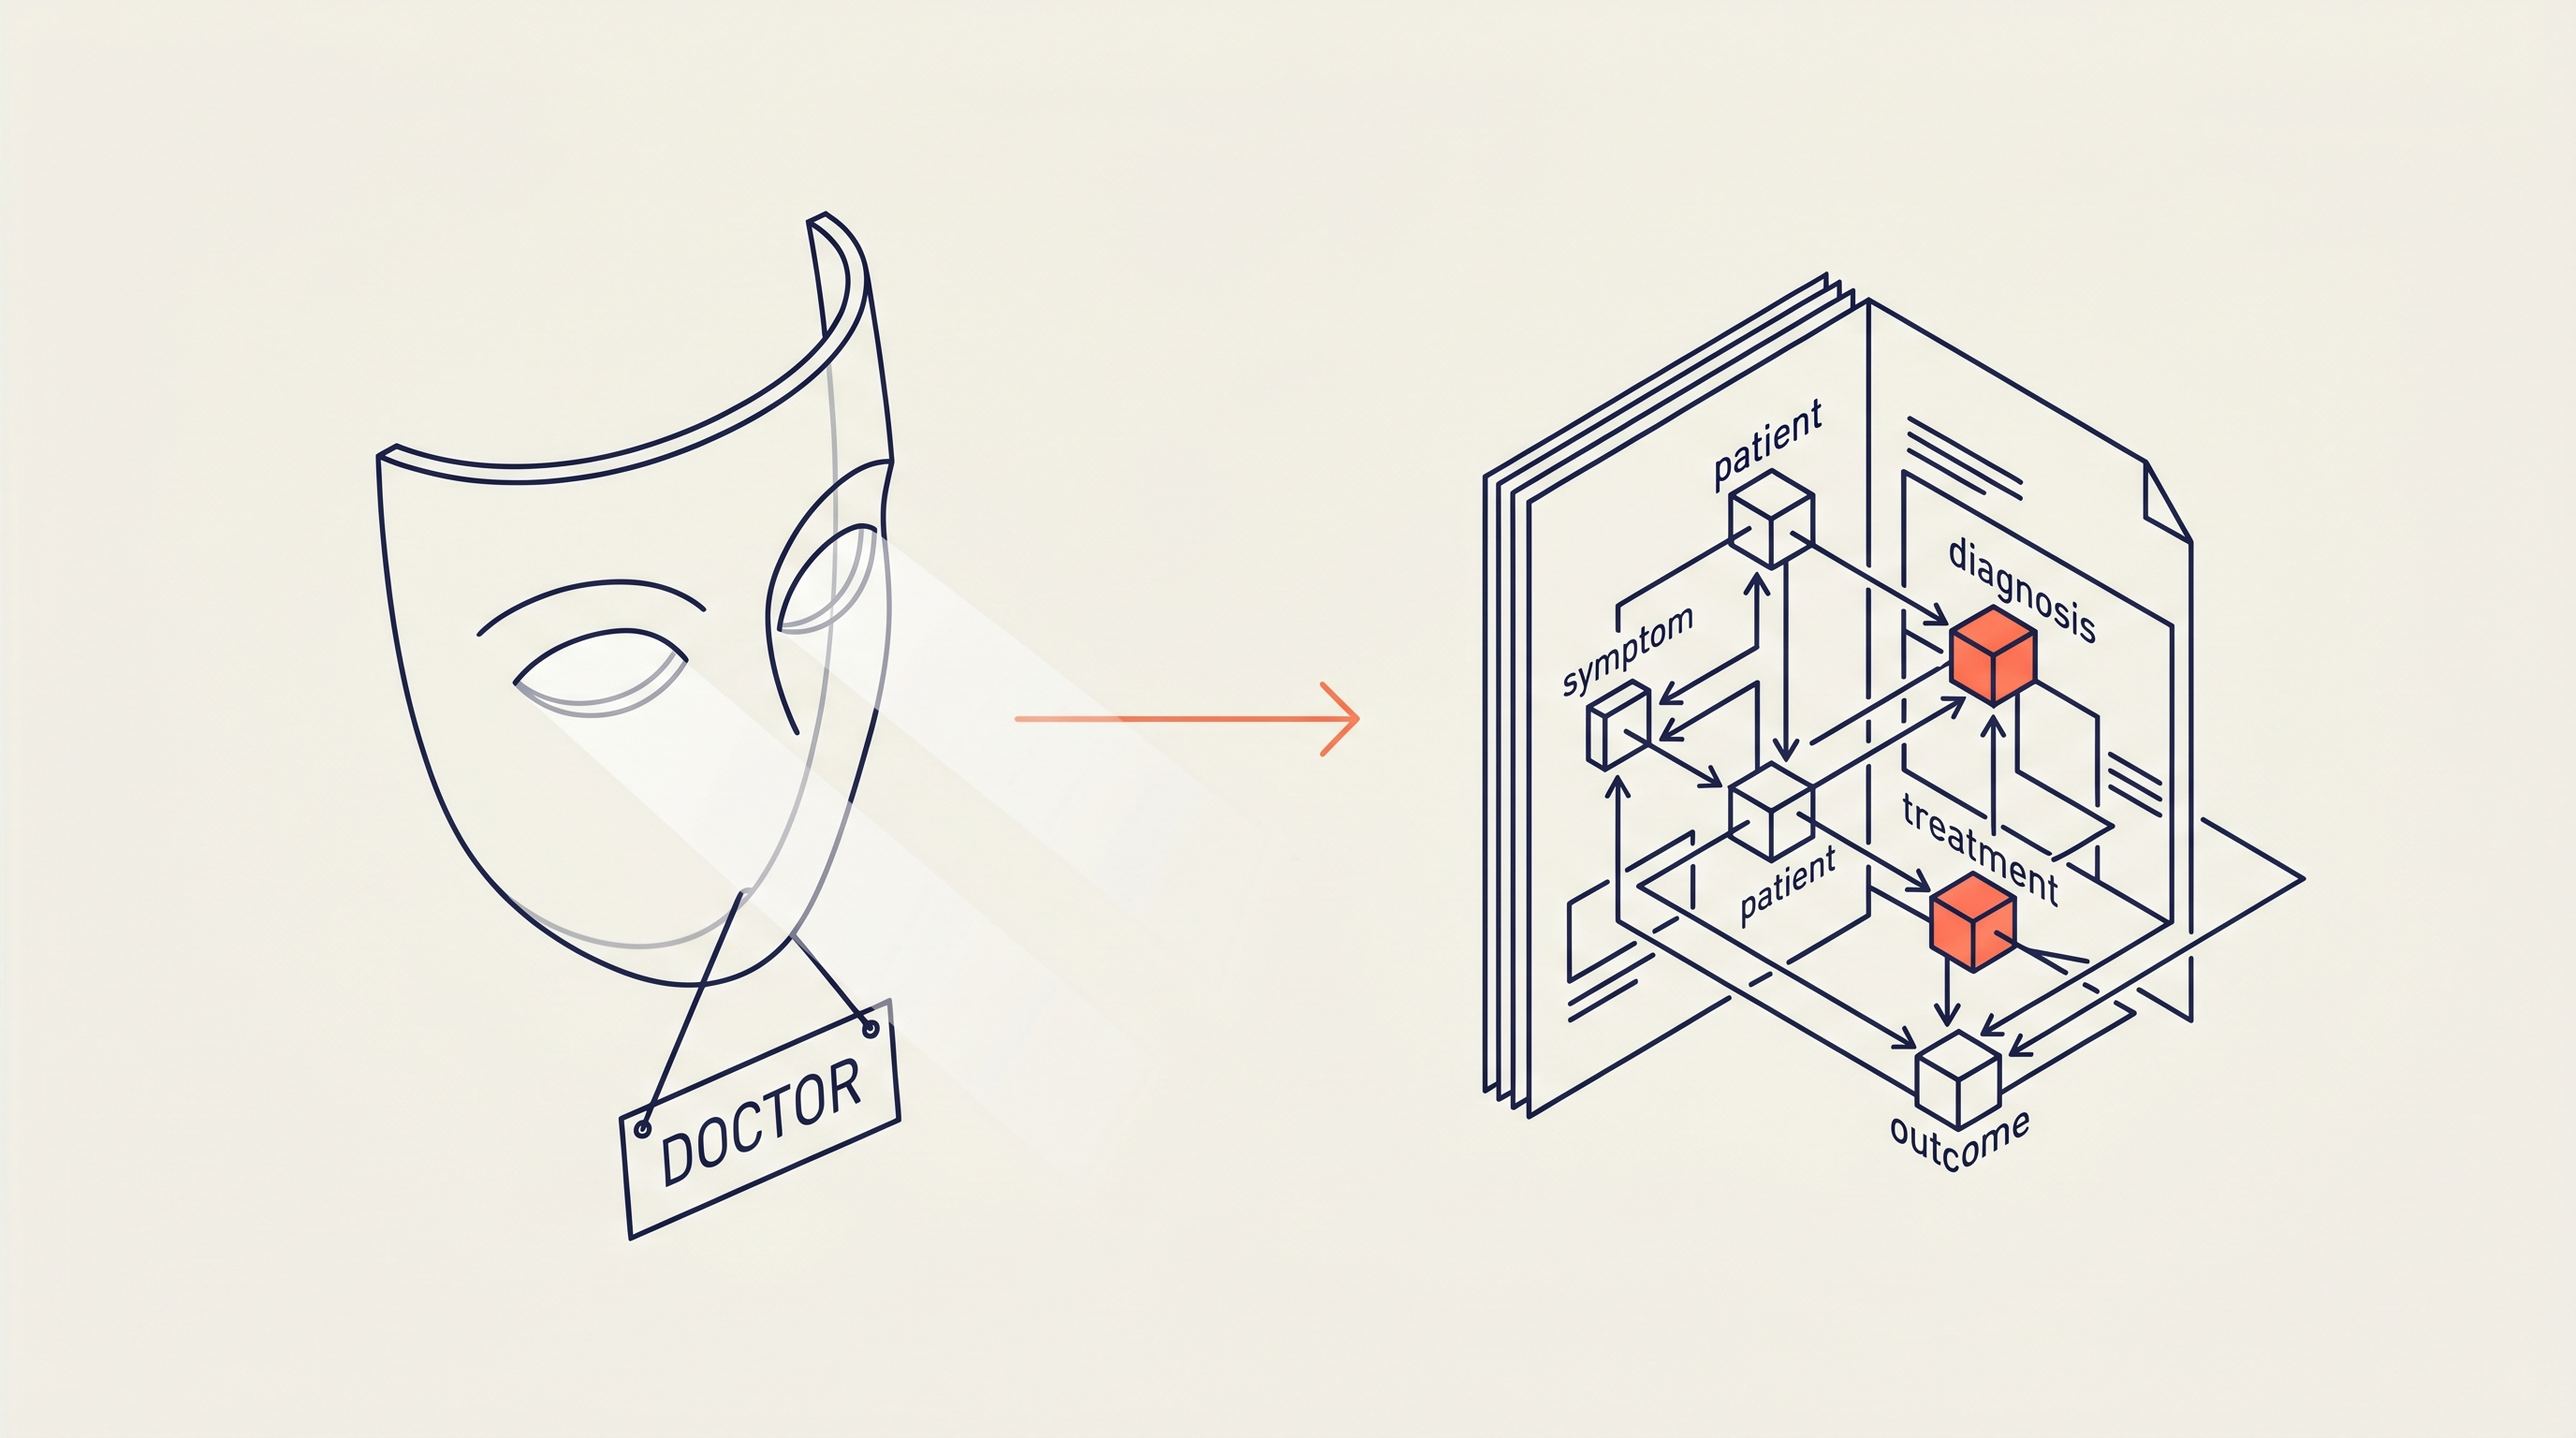 「医者」という肩書きが書かれた空の仮面は、それ自体では何の知識も持っていない。本物の専門性は患者—症状—診断—治療—結果に繋がる事実の構造から生まれる。
ChatGPTやClaudeを使う人たちが最初に学ぶテクニックがある。「あなたは医者です」 「あなたは弁護士です」 「あなはシニア開発者です」 1行でモデルに肩書きを与える。ペルソナプロンプティングと呼ばれる。
だが最近の学術ベンチマークは一貫して同じことを言っている。このテクニックは私たちが期待するほどには機能していない。 ある場合には、むしろ答えをより悪くしてしまう。
ベンチマークが示した不都合な真実
2025年12月に発表された論文(arXiv 2512.05858、「Playing Pretend: Expert Personas Don't Improve Factual Accuracy」)は、GPQA DiamondとMMLP-Proという2つの標準的な事実評価で専門家ペルソナの効果を測定した。結果はシンプルだった。ペルソナがある場合とない場合の正確性の差は統計的に意味のあるレベルではないか、あってもネガティブだった。 MMUでは全ての専門家ペルソナのバリエーションが正確性を低下させた — 平均68.0% 対 ペルソナなし時の71.6%。
過去の研究も同じ方向を指していた。arXiv 2311.10054(「When 'A Helpful Assistant' Is Not Really Helpful」)は4つのLLMファミリーに2,410個の事実質問をした。ペルソナは意味のある改善をもたらさなかった。もう一つの研究(arXiv 2603.18507)はさらに進んだ。専門家ペルソナはアライメント(望ましいトーン・態度への整合)には役立つが、正確性は低下させる。 トレードオフなのだ。
これがなぜ重要か。私たちが「あなたは医者です」と言う時に本当に望むのは医者らしいトーンではなく医者レベルの正確な答えだ。だがトーンは良くなっても答えは同じか悪くなる。AIに衣装を着せても、その中の俳優の実力は変わらない。
なぜこんなことが起こるのか
演劇の比喩で説明すると直感的だ。「医者になりきって演技しろ」と言った瞬間、モデルは2種類の資料を一緒に引き出す。本物の医学知識と、医者が登場する小説・ドラマ・シナリオ。arXiv 2406.17260(「Mitigating Hallucination in Fictional Character Role-Play」)が整理したメカニズムがまさにこれだ。キャラクター幻覚(character hallucination)— モデルがキャラクターのアイデンティティと知識の境界を超えた応答を生成する現象。医者ペルソナは医者を真似た出版物も一緒に呼び出す。
さらにペルソナそのものが情報量を増やさない。モデルの中に医者の知識が1あれば、ペルソナをあげても1だし、なくても1だ。肩書きは保有知識を増幅させない。 ただその知識を「医者らしいトーンで」取り出すだけだ。
ここが利用者がよく誤解する場所だ。「高度な利用者は皆ペルソナを使うから、真似れば彼らのレベルになれる」という前提。実際にはOpenAIやAnthropicが利用者データから学んでいるのは肩書きをどう与えるかではない。彼らが追うのは別の次元のパターンだ。
会社が本当に学んでいること
大規模モデル企業のRLHF(人間フィードバック強化学習)パイプラインを見れば一つのことが明確だ。彼らが集めた高度な利用者データは「どんなペルソナで始めたか」ではなく**「どんな事実をどんな順序でどんな関係の中で扱ったか」**だ。どのように質問を絞り込んだか。どんな出典をどのように確認したか。答えが間違っていた時にどのように戻ったか。
専門家知識抽出(expert elicitation)研究が同じ結論に達した。arXiv 2602.02752のような最近の論文は「Recognition over Recall」原則に従う — 専門家にプロンプトを最初から書かせない。代わりに既存のプロンプトと答えを見せて、何が間違っていてどう直すべきかを批評させる。批評が累積されると作業パターンが現れる。
同じ研究分野で何度も確認された事実がある。チェーン・オブ・ソート(思考過程の表示)、フューショット(例示の提供)、検索拡張(retrieval-augmented)が専門家ロール模倣よりも一貫して正確性を高めた。 肩書き模倣は最も弱いツールだ。
では本物のツールは何か。
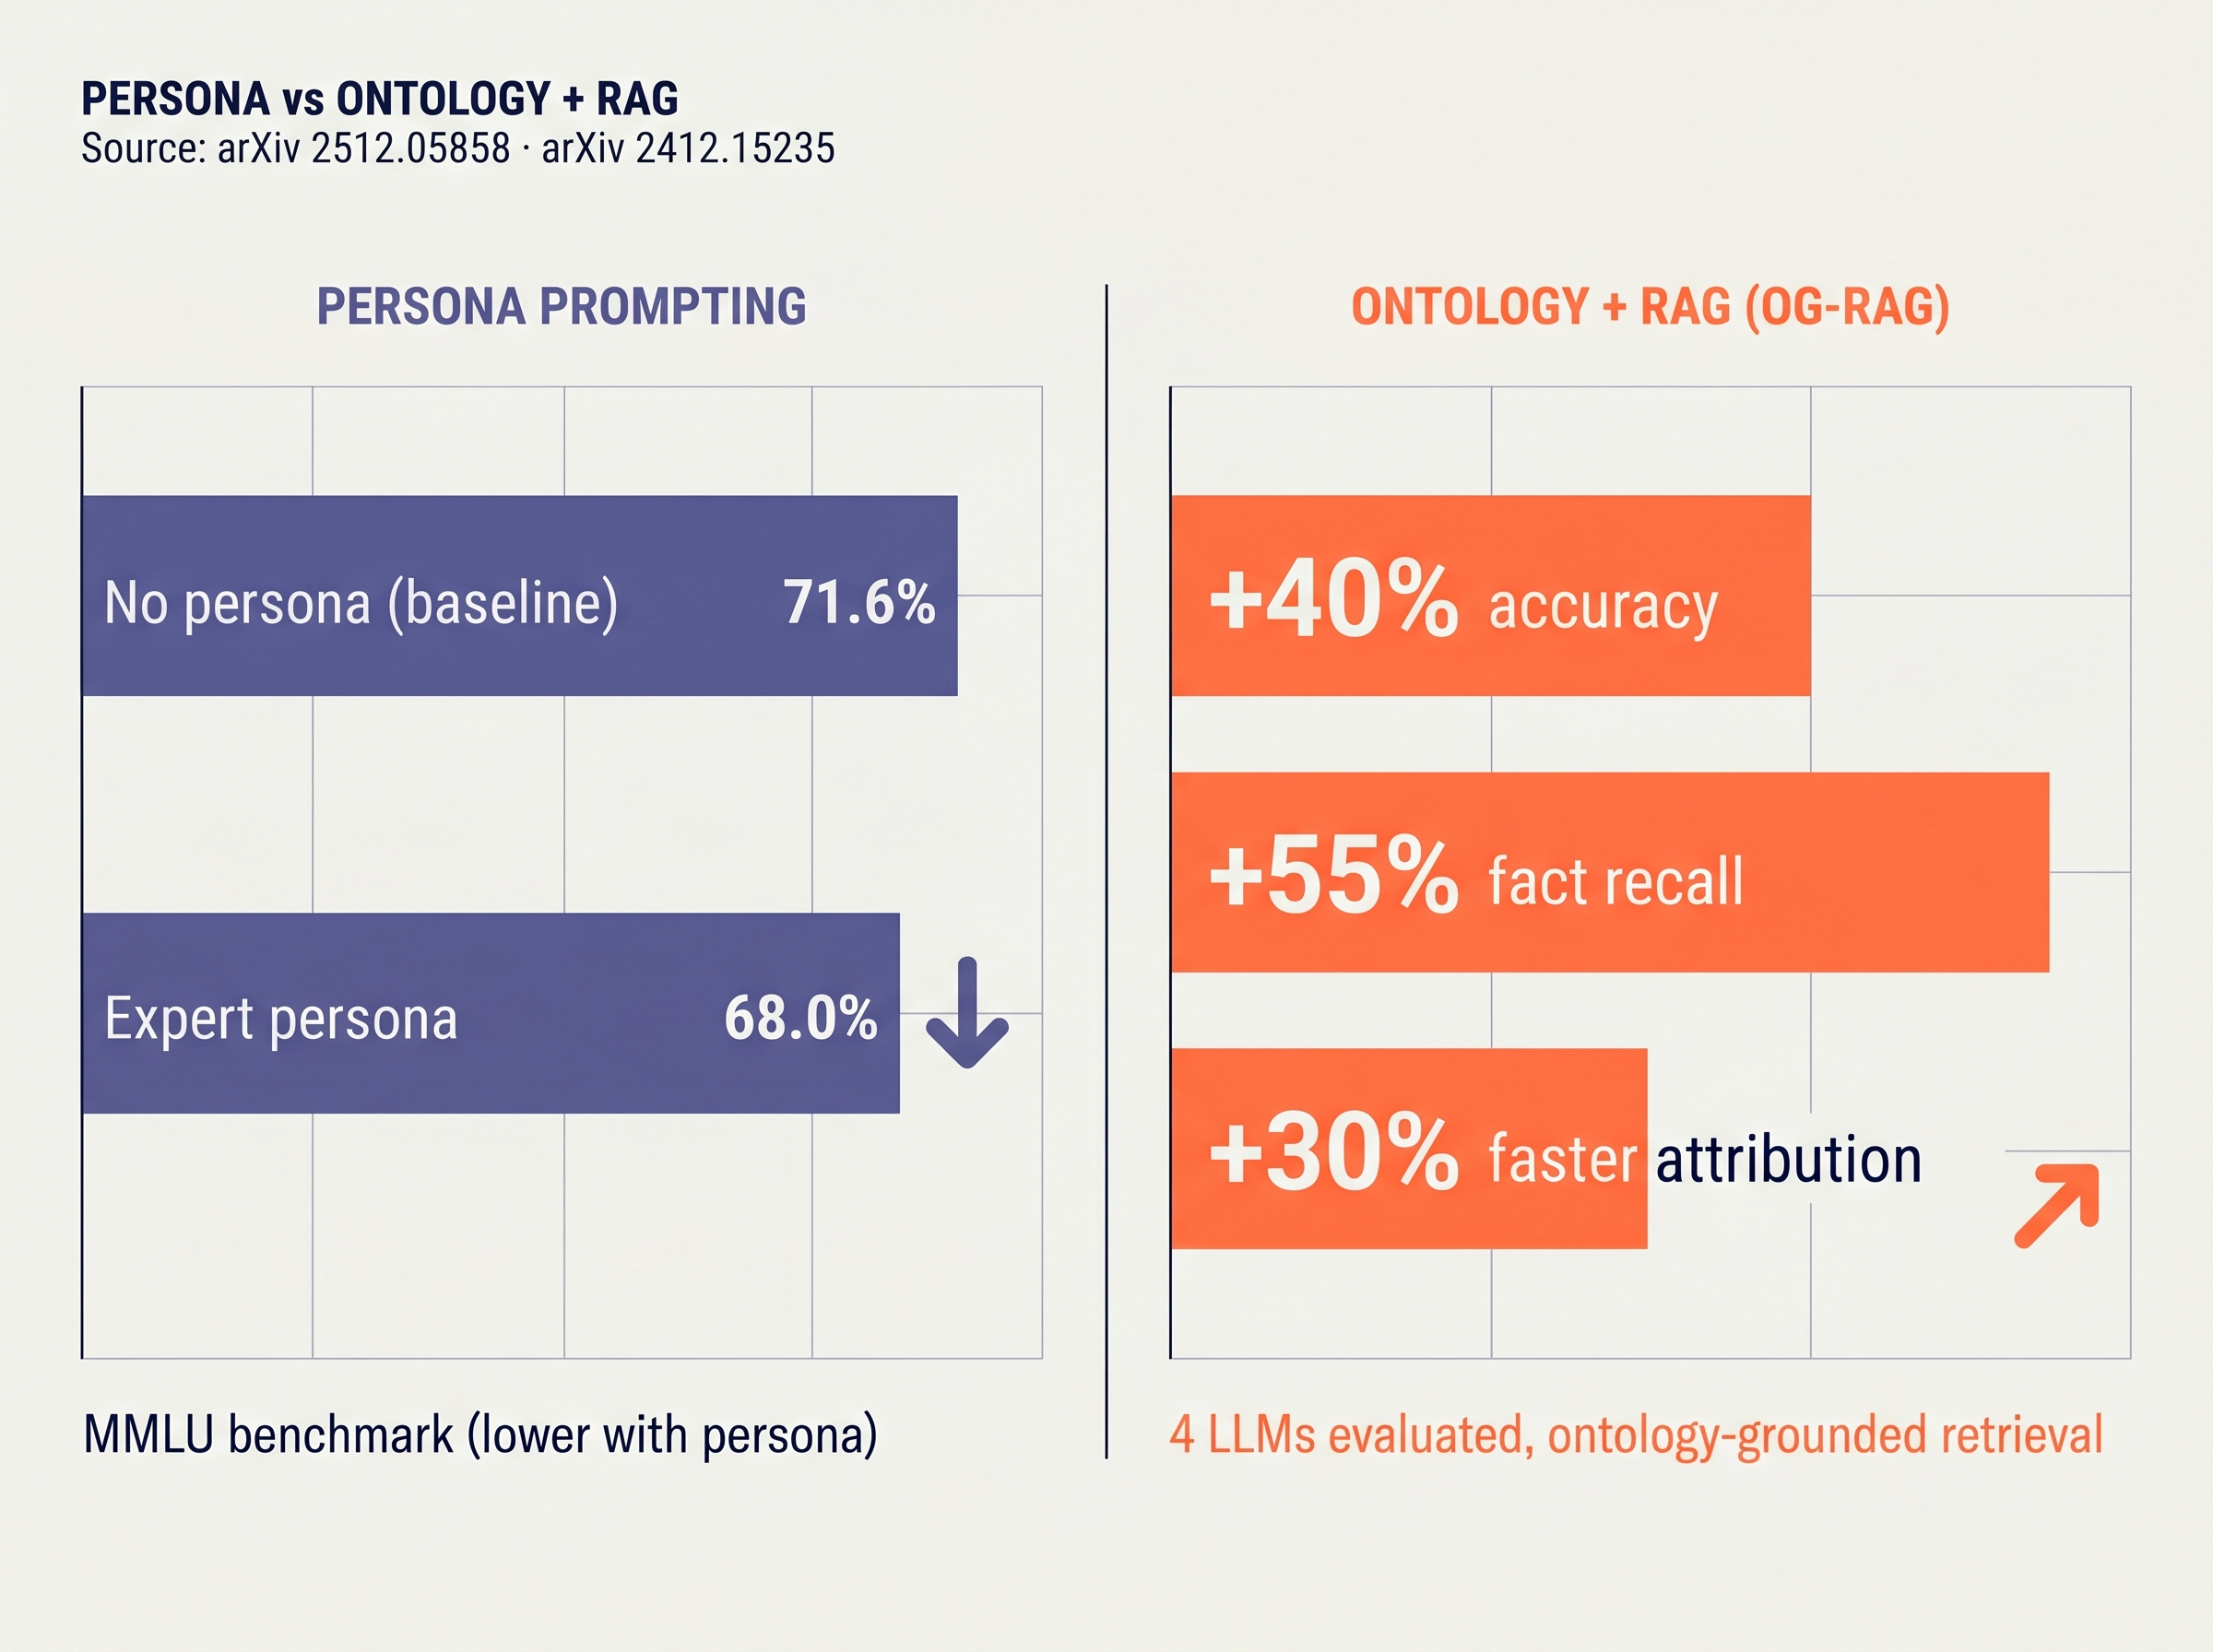 専門家ペルソナはMMUの正確性を71.6%から68.0%に低下させた(arXiv 2512.05858)。同時期に、オントロジーに基づくRAG(OG-RAG)は事実抽出率 +55%、応答正確性 +40%、出典追跡 +30% 高速化を記録した(arXiv 2412.15235)。
事実の構造をモデルの隣に埋め込む — オントロジーとRAG
ペルソナが「私は誰かのふりをする」なら、反対の端には「何が事実かをモデルの隣に直接敷き詰める」がある。2つのテクノロジーで実装される。
RAG(Retrieval-Augmented Generation、検索拡張生成) — モデルが答える直前に関連文書を引き出して一緒に見せる。モデルが暗記した知識ではなく、今引き出した文書に基づいて答えさせる。
オントロジー(ontology) — 1つのドメインの概念・関係・規則を明示的に記述した地図。「患者—症状—診断—薬物—副作用」のように事実がお互いにどのように繋がるかを構造で埋め込んだもの。
この2つを組み合わせたOG-RAG(Ontology-Grounded RAG)についての2024年12月の論文(arXiv 2412.15235)は4つのLLMにかけた実験で以下を測定した。事実抽出率 55% 向上、応答正確性 40% 向上、出典追跡 30% 高速化。 ペルソナプロンプトが示さなかった数値変化がここで現れる。
業界では既に定着している。Microsoft Researchが公開したGraphRAGは、非公開文書からエンティティと関係を抽出してグラフにし、答える時にこのグラフを一緒に参照する。Neo4jは同じ流れのGraphRAGツールを作り、エンタープライズRAGシステムの標準コンポーネントとして推し進めている。法律・医療・金融のような事実が重い分野ほどこの方向が強い(arXiv 2505.00039 — 法律ドメイン用Ontology-Driven Graph RAG)。
「それは高い会社の話ではないのか」
ここで一般人がよく立ち止まる。オントロジーを作りRAGパイプラインを立ち上げることはエンジニアの領域に見える。その通り、正式なシステムはそうだ。しかし個人利用者にも同じ原理が小さなユニットで移植されている。
ClaudeのProjects、NotebookLM、ChatGPTのCustom GPTのようなツールは本質的に個人用RAGだ。あなたが自分のドメインの文書をその中に入れておけば、モデルは答える時にその文書を優先参照する。肩書きを真似るのではなく、本物の事実を隣に置いて答える。
オントロジーはより単純に始められる。自分の仕事の事実構造を文に書き留めることがそのまま小さなオントロジーだ。 医者なら「私が見ている患者層—主な訴え—診断基準—私がよく処方する薬物範囲—注意すべき副作用」を1ページにまとめる。弁護士なら「私が扱う事件タイプ—適用法令—判例の流れ—依頼人の典型的な誤解」。デザイナーなら「私が使うデザイン原則—参考事例フォルダ—クライアントがよく使う誤った用語とそれが本当に意味すること」。
この1ページをモデルにいつも一緒に与えれば、ペルソナで100回真似たより遥かに正確な答えが出る。理由はシンプルだ。モデルが推測しなければならない領域を人間が先に書いてあげたからだ。
 AIを上手に使うということは結局のところ、自分のドメインの事実構造を手で整理するということだ。ペルソナ1行は5秒で書けるが、その効果も5秒分だ。
AIを上手に使うことの真の意味
この地点で1つのことが明確になる。AIを本当に上手に使うということは1行の魔法の呪文を見つけたということではない。自分の仕事の事実構造を明確に整理できるということだ。 それがRAGに入る文書になり、小さなオントロジーになり、モデルがどんな情報をどんな順序で扱うことを望むかについての仕様になる。
これは軽い作業ではない。自分のドメインを最初から書くことは自分の仕事を最初から見直すことだ。何が本当の中核で、何が慣行的についてきた外皮なのかを見分けなければならない。時間がかかる。執拗さが必要だ。そして一度作ると、モデルが変わってもその資産は残る。
ペルソナプロンプトは5秒で書ける。だからその効果も5秒分だ。自分のドメインで事実の構造を整理する作業は数日、もしくは数ヶ月かかる。その効果も数日・数ヶ月分だ。AIで仕事するということは結局のところ、仕事をより深く行うということと同じだ。 AIが仕事の代わりをしてくれるわけではない。AIでより上手く仕事するために人間がより精密に仕事する。
今日試してみる2つのこと
1つ目。 自分のドメインの「1ページ」を書いてみよう。中核となる概念5~10個、その間の関係3~5個、よく起こる誤解2~3個。次のAI作業の時にこのページをシステムプロンプトやプロジェクトコンテキストに一緒に入れて、「あなたは[私の職業]です」だけを入れた時の答えと比較してみよう。差が見えるだろう。
2つ目。 普段「あなたはX専門家です」で始まるプロンプトがあれば、その1行を外して代わりに**「このタスクで扱うべき事実:[リスト]」と「このタスクで絶対に推測しないこと:[リスト]」**を書いてみよう。モデルは肩書きではなく境界と規則で仕事をする。
肩書きを呼ぶな、事実を敷き詰めよ。それが会社が学んでいる高度な利用者の本当のパターンだ。
参考文献:
- arXiv 2512.05858 — Playing Pretend: Expert Personas Don't Improve Factual Accuracy
- arXiv 2311.10054 — When "A Helpful Assistant" Is Not Really Helpful
- arXiv 2603.18507 — Expert Personas Improve LLM Alignment but Damage Accuracy
- arXiv 2406.17260 — Mitigating Hallucination in Fictional Character Role-Play
- arXiv 2412.15235 — OG-RAG: Ontology-Grounded Retrieval-Augmented Generation
- arXiv 2505.00039 — An Ontology-Driven Graph RAG for Legal Norms
- Microsoft Research — GraphRAG: Unlocking LLM Discovery on Narrative Private Data
- Neo4j — Unifying LLMs & Knowledge Graphs for GenAI
- Anthropic — Effective Context Engineering for AI Agents
この記事に含まれるイメージはAIイメージ生成モデル(Gemini 3 Pro Image)で制作され、英陽郡AI協会テックデスクの編集監修を経ている。
この記事は明星心齋の深層思考エンジン
Simthink Engine (深 Think)により執筆されました。