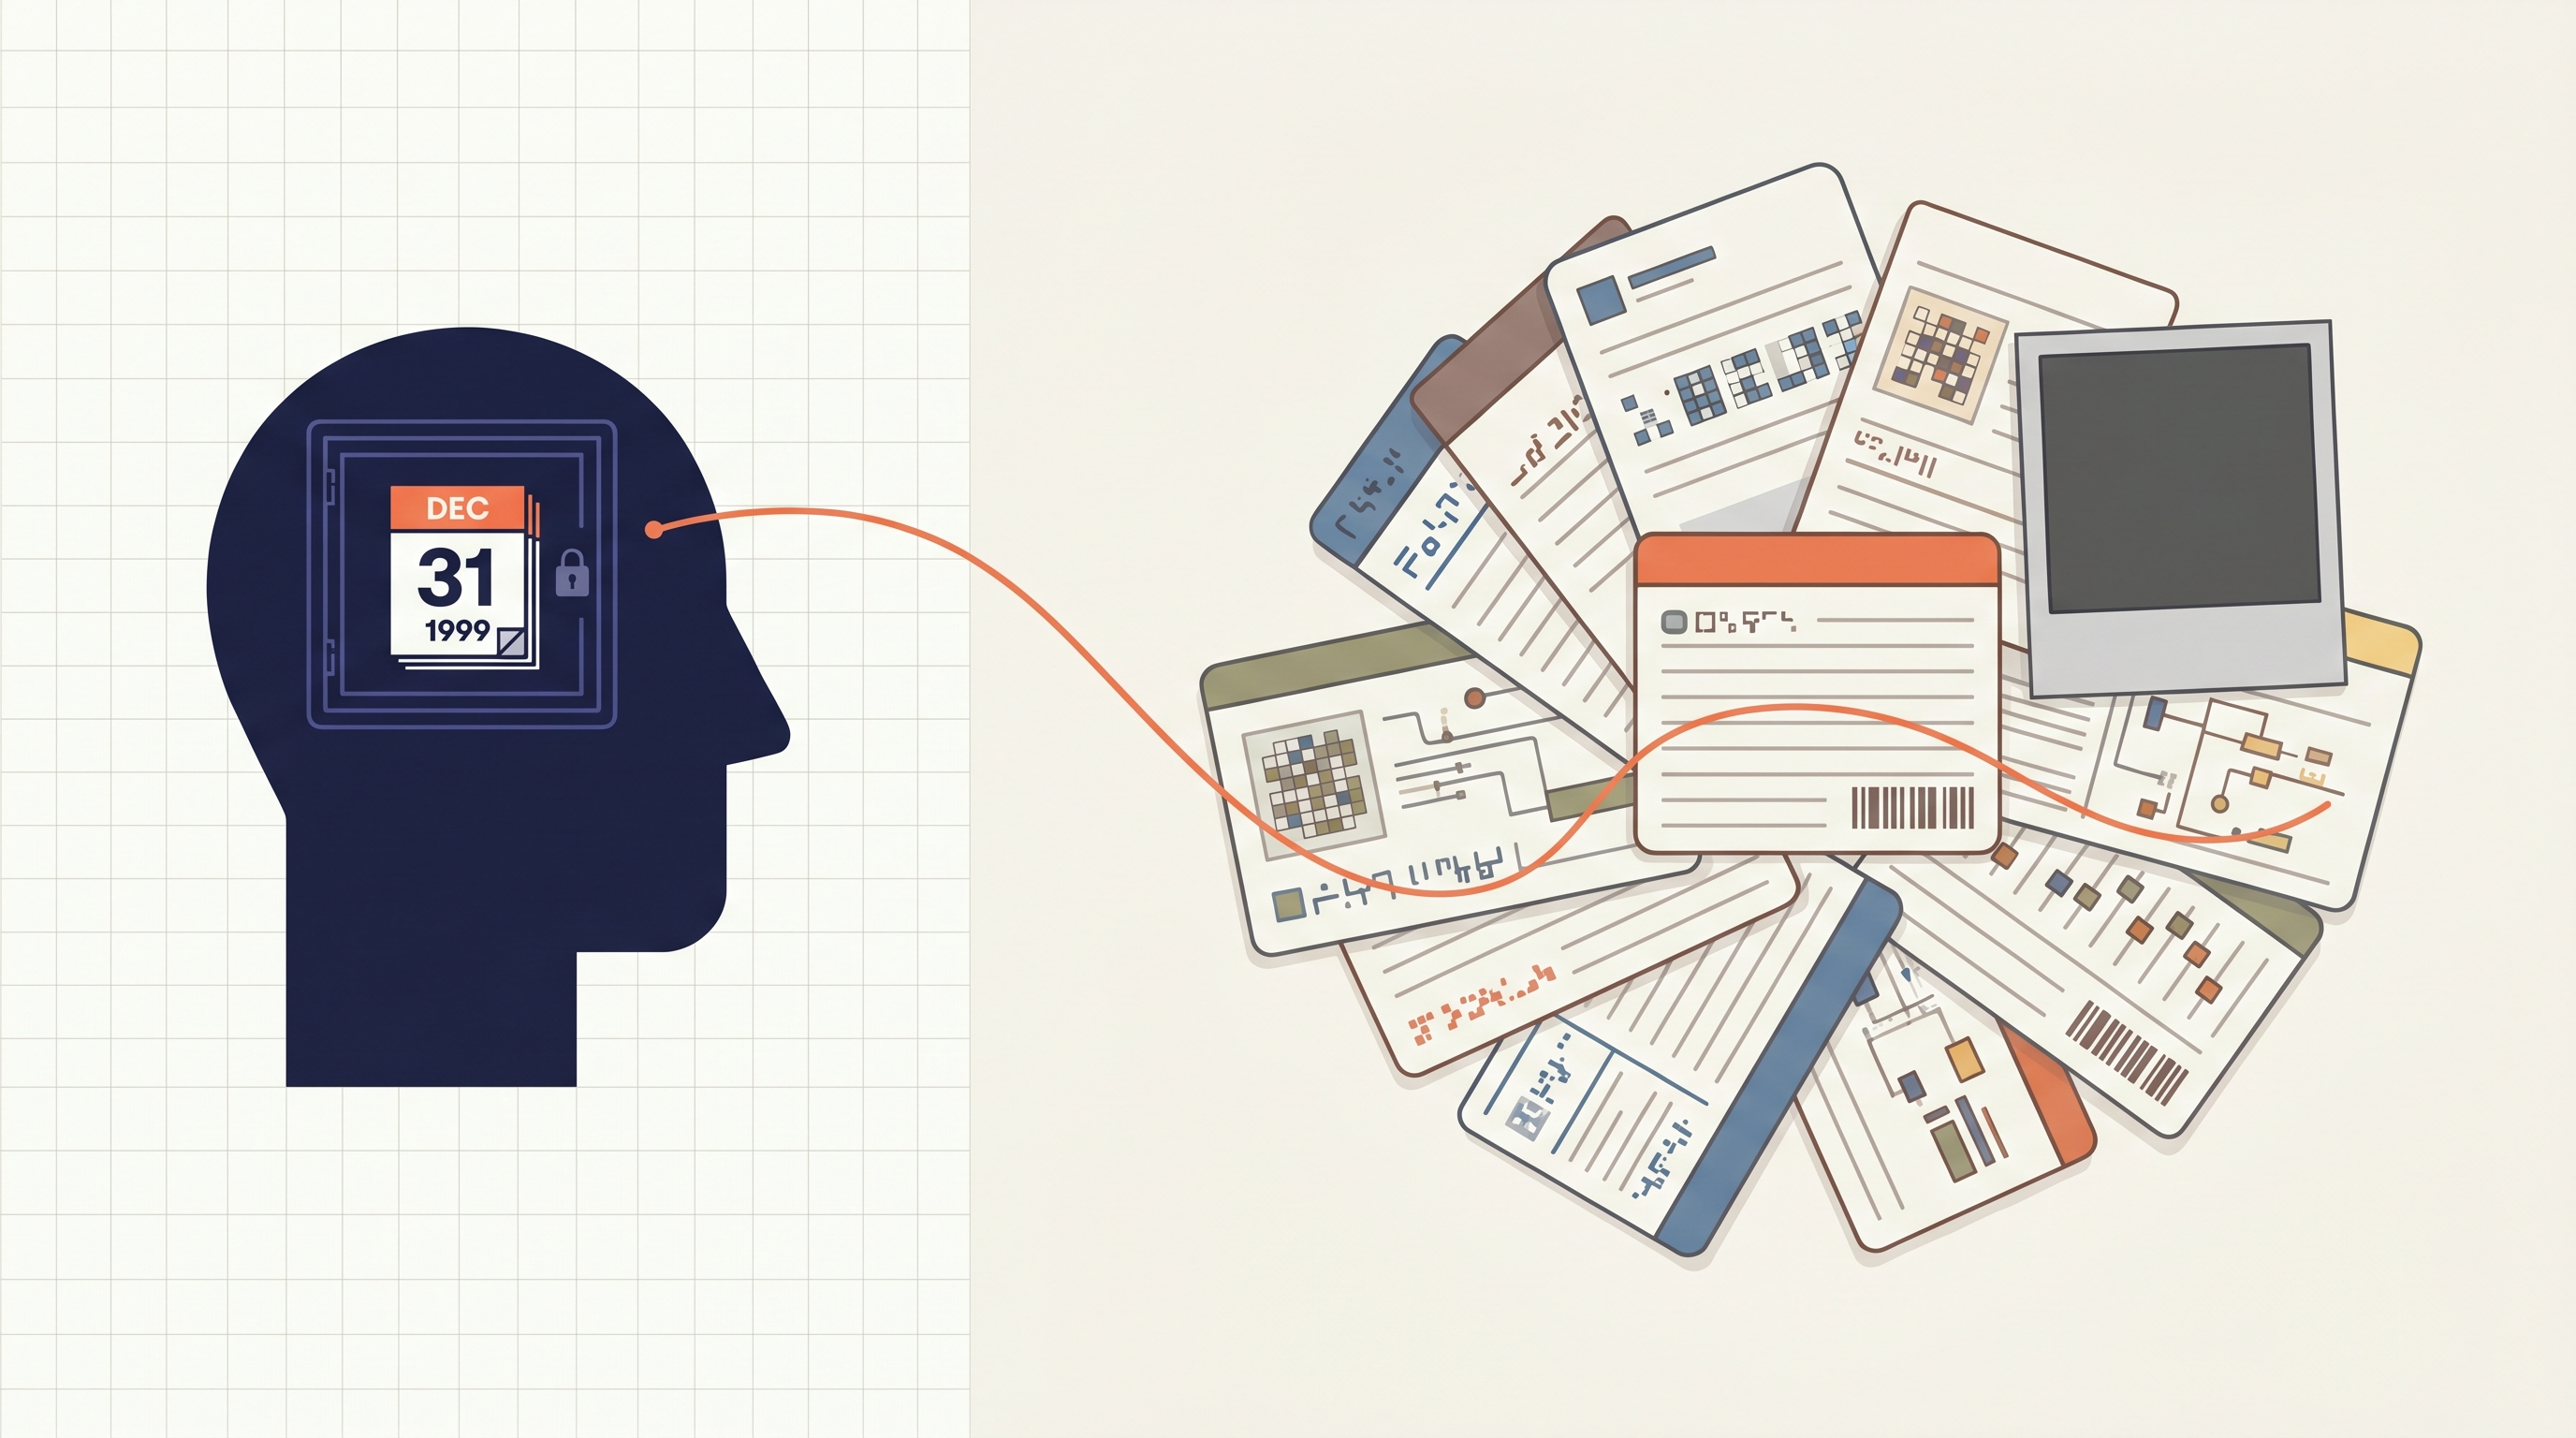
1999年12月31日に施錠されている――LLMの頭の中に凍結された知識カットオフのポイント。本当の答えはその横に広がるメモ帳から生まれます。
レナードとChatGPT――AIが賢くなった本当の瞬間はモデルの外で起こった
クリストファー・ノーランが2001年に発表した映画『メメント』の主人公レナードは、事故後、新しい記憶を10分以上保つことができません。彼はポラロイド写真を撮り、その裏にメモを書き、絶対に忘れてはいけない事実は自分の体に入れ墨として刻んでいます。映画のあらゆる推理はレナードの頭の中ではなく、彼が持ち歩く写真とメモ帳の中で起こります。
ここ数年、人工知能業界で起きた最大の変化も同じような形をしています。唯一の違いは、カメラを持っているのが人間ではなく、AIそのものだということです。
天才だが毎回初めからやり直す人
大型言語モデル(LLM、ChatGPTやClaudeのようなテキスト読み書きAI)の正体を一文に圧縮するなら、こうなります。ある時点までインターネットに投稿されたほぼすべてのテキストを読んだが、その後一文字も追加で見ていない人。この時点を業界では「知識カットオフ(knowledge cutoff)」と呼びます。カットオフ以降の出来事はモデル内に存在しません。
問題は、モデル自体がそのことをよく知らないということです。知らないなら知らないと言うべきなのに、学習データのパターンに従ってもっともらしい文を生成してしまいます。これを「ハルシネーション(幻覚)」と呼びます。つまり、事実ではない内容を事実のように述べる現象です。
数字で見ると、より明確です。2025年のハルシネーション・ベンチマーク分析によると、トップティアモデルのハルシネーション率は、タスクの種類に関わらず、平均的に10~20%の範囲に集まります(SQ Magazine、2026年集計)。時点に敏感な質問――「先週誰がどんな発表をしたか」というような――について、検索ツールなしで回答したモデルのハルシネーション率は、そうでない場合の約2倍に跳ね上がります。日常的な分析タスクでも15%を超えます。
これはまさに、かつては有能な刑事だったが毎回初めからやり直さざるを得ないレナードと全く同じです。事故前の推理能力は無傷のままなのに、事故後のことについては聞くべきではありません。
ポケットの中のポラロイド
レナードの解決策は脳の中ではなく、ポケットの中にあります。誰かが「あの人は誰だ」と聞くと、彼は自分の記憶を搾り出す代わりに、自分の写真の山を掘り返し、その顔が写ったポラロイド一枚を引き出します。写真の裏には、自分の手書きで「テディ。彼の嘘を信じるな」と書かれています。写真とメモを見た後にのみ、彼は口を開きます。
技術業界では、この動作を「RAG(検索増強生成)」と呼びます。これは2020年にFacebook AI Researchのパトリック・ルイス研究チームがarXiv:2005.11401で最初に正式化した概念です。この論文はLLMの重みに組み込まれた知識を「パラメトリック・メモリ(parametric memory)」と呼び、別に離れたデータベースを「非パラメトリック・メモリ(non-parametric memory)」と呼びます。RAGはこの両方のメモリを同時に使う構造です。
動作手順は三段階で完了します。
まず、検索(Retrieval)。ユーザーが質問すると、システムは最初に外部ストレージから関連ドキュメントを取り出します。このストレージは会社の内部マニュアルかもしれませんし、昨日のニュース束かもしれませんし、自分が過去5年間に受け取ったメールかもしれません。レナードの写真の山に相当します。
次に、増強(Augmentation)。取り出したドキュメントを質問と一緒にモデルに提示します。「この資料に基づいて答えよ」と明示します。写真の裏のメモを目の前に広げる段階です。
最後に、生成(Generation)。モデルは自分の頭の中の知識と提示された資料を合わせて答えを作ります。レナードがメモを読んで「君はテディだ。だが僕は君を信じない」と口を開く、その瞬間です。
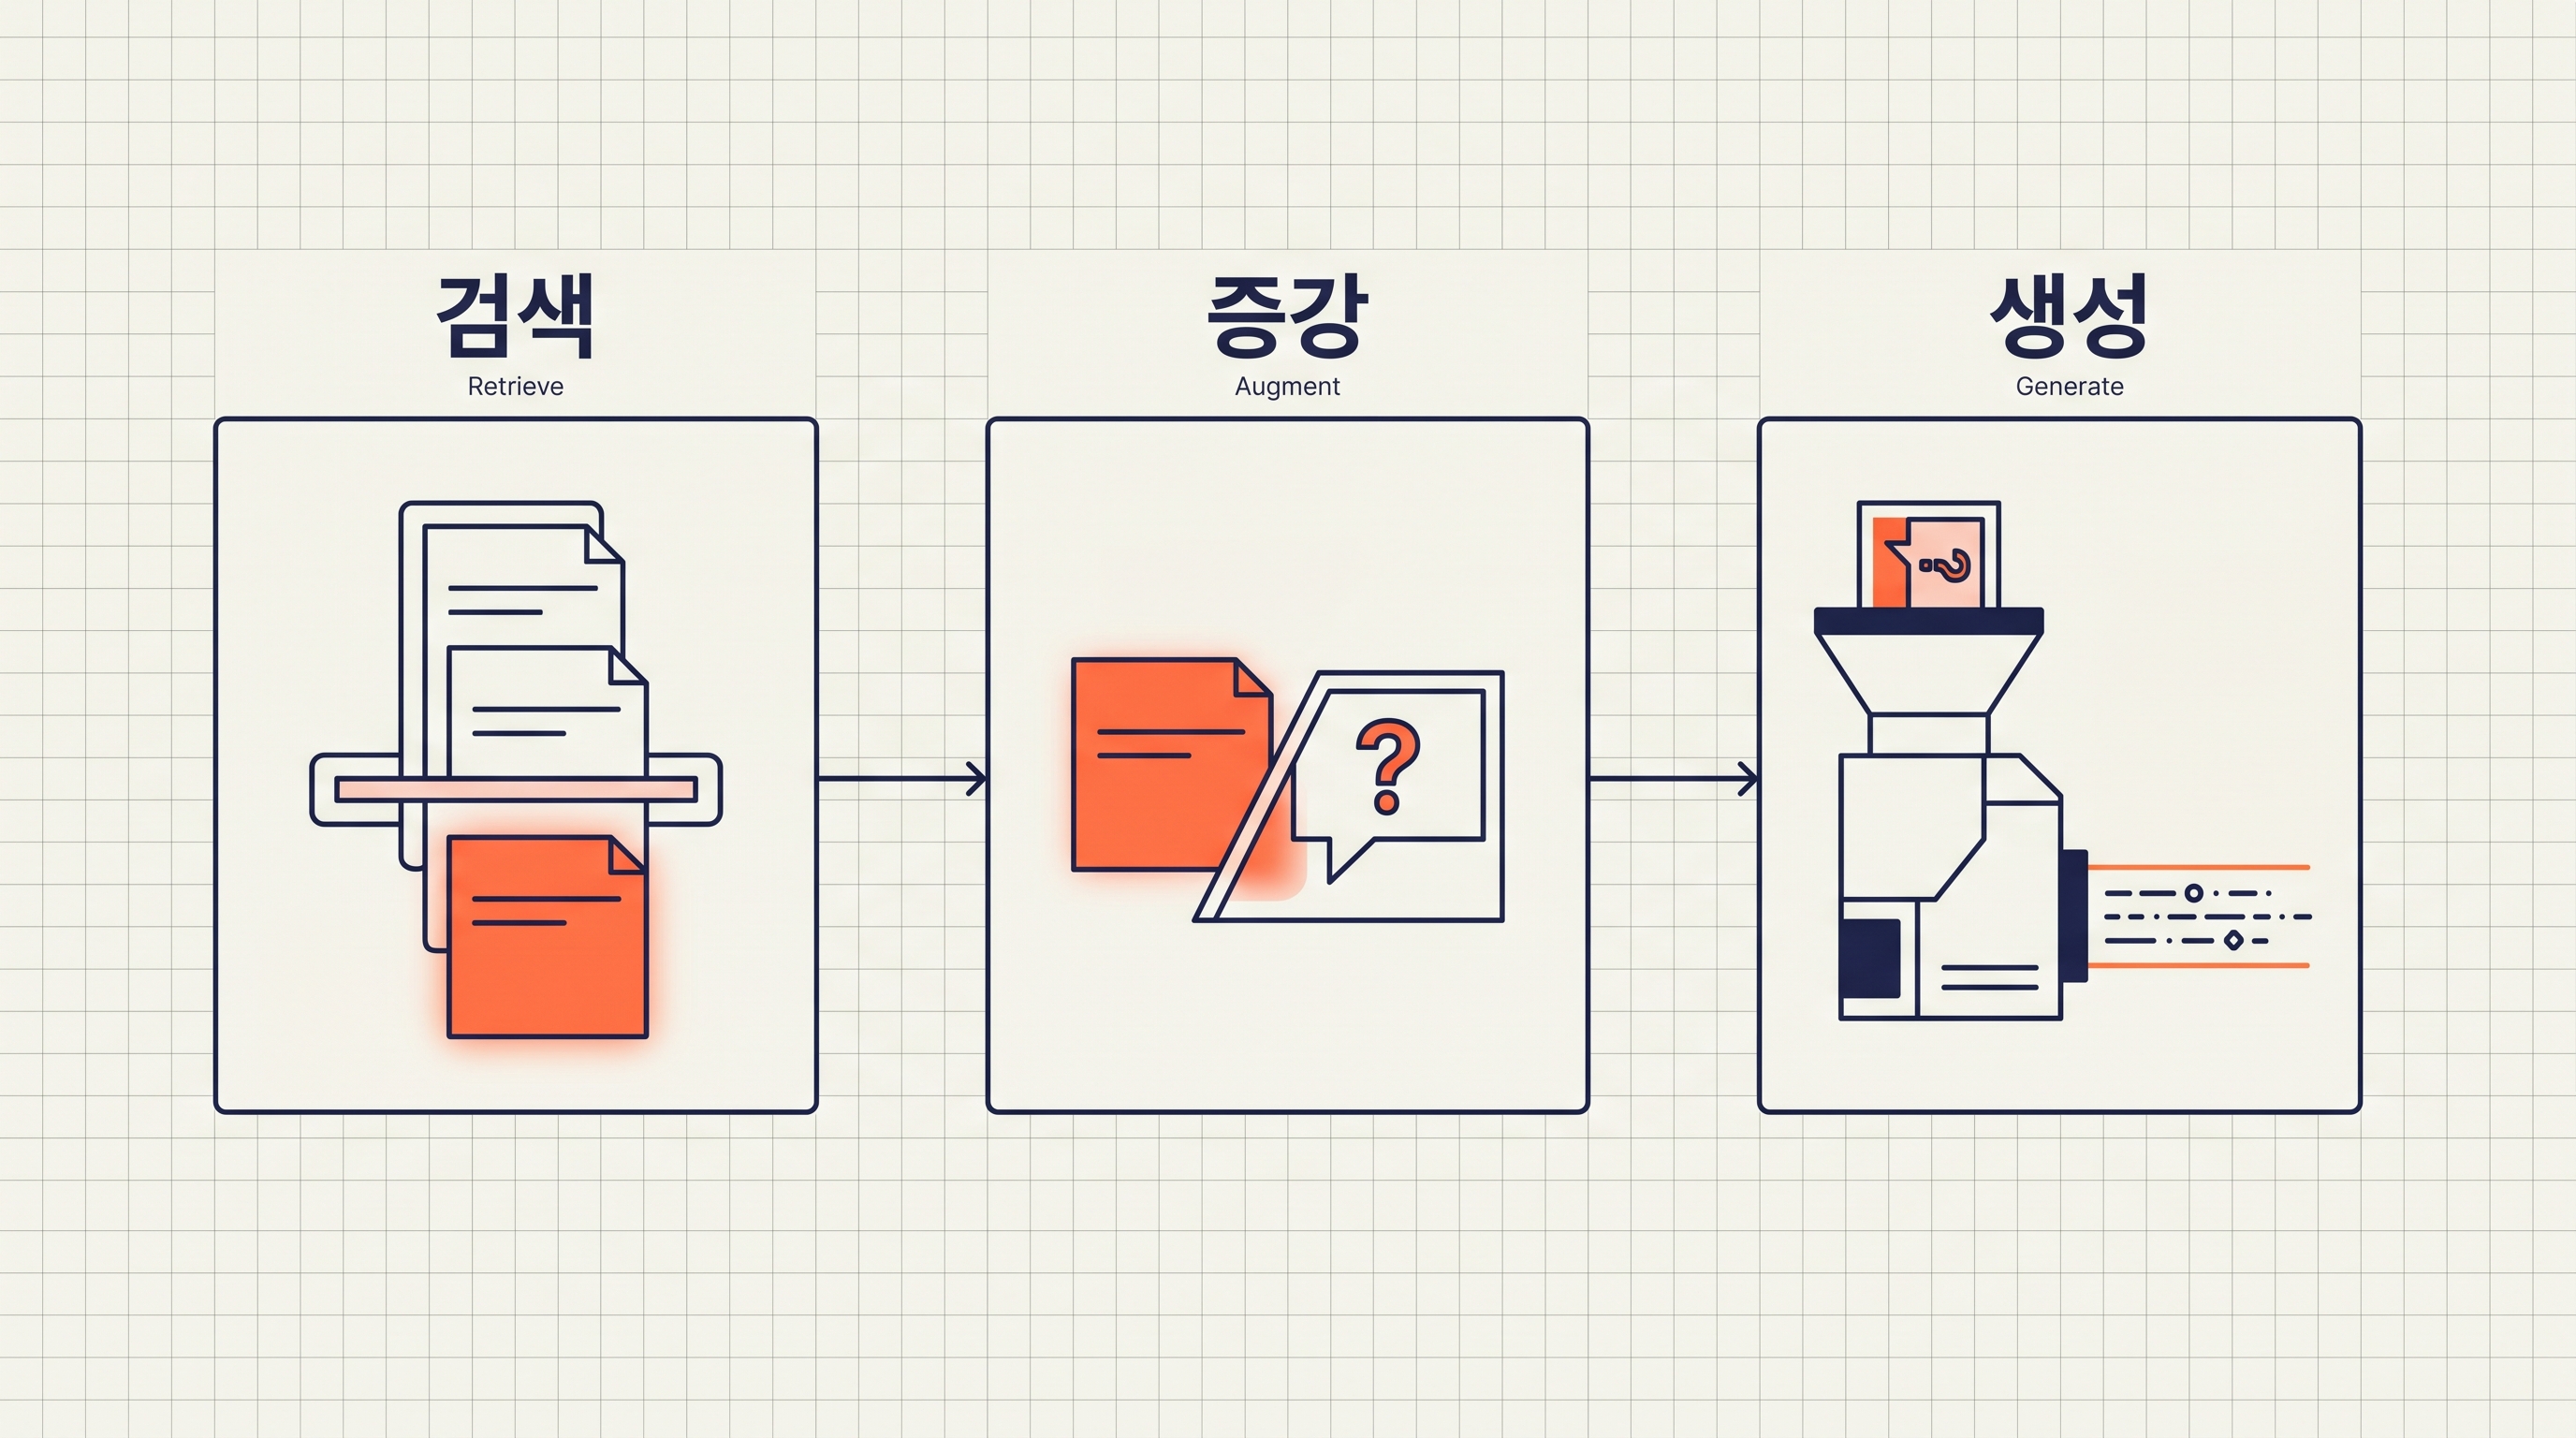
RAGの三段階。検索が資料を選び出し、増強がそれを質問に貼り付け、生成が答えを絞ります。
みんなが急に記録を作り始めたワケ
なぜこの構造が急にすべての企業に広がったのでしょうか。答えは時間とコストです。学習が終わったモデルに新しい情報を詰め込むには、モデル全体を再度学習させなければなりません。数十億円がかかり、数週間を要します。一方、外部ストレージにPDF一枚をアップロードするのに必要な時間は1分です。会社が昨日発表した新製品マニュアルを、AIが今日答えられるようにする最速ルートがRAGでした。
導入速度は数字で確認できます。2025年の産業調査をまとめると、企業が採用する生成AI使用例の30~60%の範囲がRAG構造の上で動作しています。同じ年のMcKinseyの『State of AI』調査では、回答企業の71%が何らかの形で定期的に生成AIを使用していると報告されています(McKinsey, 2025)。産業別に見ると、法律・医療・金融のような「事実関係を間違えたら終わり」という分野ほどRAG依存度が高くなります。
興味深い点は、同じ調査の別の行です。71%が使用していると答えたが、実際の営業利益(EBIT)に5%以上貢献していると答えた企業は17%に過ぎませんでした。導入と価値の間に深い溝があるということです。記録を作り始めたことと、記録をうまく使うことは同じことではありません。
しかし、記録も嘘をつく
ここで映画のもう一つの重要な瞬間が思い浮かびます。『メメント』の衝撃は、レナードがメモを持ち歩くという事実ではなく、その記録を彼自身が間違って書いた可能性があるという事実にあります。間違って撮られた写真、誤って解釈された手がかり、意図的に歪められた一行。RAGでも全く同じことが起こります。
スタンフォード大学のRegLabは2024年、LexisNexisとThomson Reutersの法律AIツールを検証しました。どちらのツールもRAG構造上で運営されています。結果は冷たいものでした。回答の17~33%が、ハルシネーションであるか、出典を誤って引用したものとして分類されました(Magesh et al., Journal of Empirical Legal Studies, 2025)。RAGがハルシネーションを減らすことは事実です。同時期の学術レビューは、RAGがハルシネーションを40~71%減らしたと報告しています。しかし、減らしたことは排除したことを意味しません。
原因は二つに分かれます。一つは検索段階の失敗です。資料が不十分であったり、質問を誤解して的はずれなドキュメントを取り出したり、重要な段落が検索結果の途中に埋もれてモデルが無視する場合があります(これを「lost in the middle」現象と呼びます)。もう一つは生成段階の欠陥です。モデルが検索結果と自分の学習データが衝突するとき、学習データを優先させたり、資料にない内容を自信を持って追加したりするケースです。
映画に戻ると、レナードが真実に到達できなかった本当の理由は、メモ帳が不足していたからではなく、記録する瞬間がすでに揺らいでいたからです。道具はそれを使う人間の精度を超えることはできません。
この記事の一行。
あなたの机の上のRAG
なぜこの話が自分の仕事と関わるのか。実のところ、あなたはすでにRAGを使っています。
診療所の医者は頭の中の知識だけで処方を決めたりしません。画面に臨床ガイドラインを表示させて見ます。弁護士はすべての判例を暗記していません。検索します。会計士は税法条文を手引書で確認し直します。教師は教科書を開いて授業を組み立てます。営業担当者は昨日作成した取引ノートを見直してからミーティングに入ります。これらすべての動きが、まさに検索・増強・生成です。頭の中の知識は推論を担当し、外部に保管した資料は事実関係を担当します。
AIに仕事をさせるときも同じパターンを使えば、結果が変わります。最もシンプルでありながら最も効果が大きい二つを推奨します。
まず、モデルに資料を先に握らせます。ChatGPTやClaudeに質問するとき、自社の資料、自社の産業レポート、自社の営業データをPDFでアップロードして、「この資料に基づいて答えよ」と明示します。モデル内の曖昧な一般知識の代わりに、自分の具体的な資料が答えの根拠になります。
次に、答えを受け取るときに「どのページのどの文からその結論が出たのか」という出典を一緒に要求します。出典を示すことができない答えはハルシネーションの可能性が高いです。『メメント』を見た人なら、レナードが写真の裏のメモを見ずに口を開いたときに映画がどのように進んだかを知っています。
本当の変化はモデルの内側で起きたのではなく、モデルの隣に置いたメモ帳で起きました。そしてメモをどのように書くかが、結局のところ答えの品質を決定します。AI時代をうまく生きる人は、より賢いモデルを探し回る人ではなく、自分の領域のメモ帳をうまく作り、うまく検索して、うまく提示する人です。
レナードの写真は彼を救いませんでした。しかし、メモをどのように書くかは、私たち自身が決定することができます。それが映画と私たちの仕事の違いです。
申致訓 영양군AI協会 — yyaia.org
この記事に含まれる画像は、AI画像生成モデル(Gemini 3 Pro Image)で制作され、영양군AI協会テックデスクの編集査読を経ています。
この記事は明星心齋の深層思考エンジン
Simthink Engine (深 Think)により執筆されました。