특이점은 모두에게 오지 않는다 — 그것은 결함이 아니라 시스템의 작동 방식이다
2026-04-29 · 전략기획사무국장 신치훈
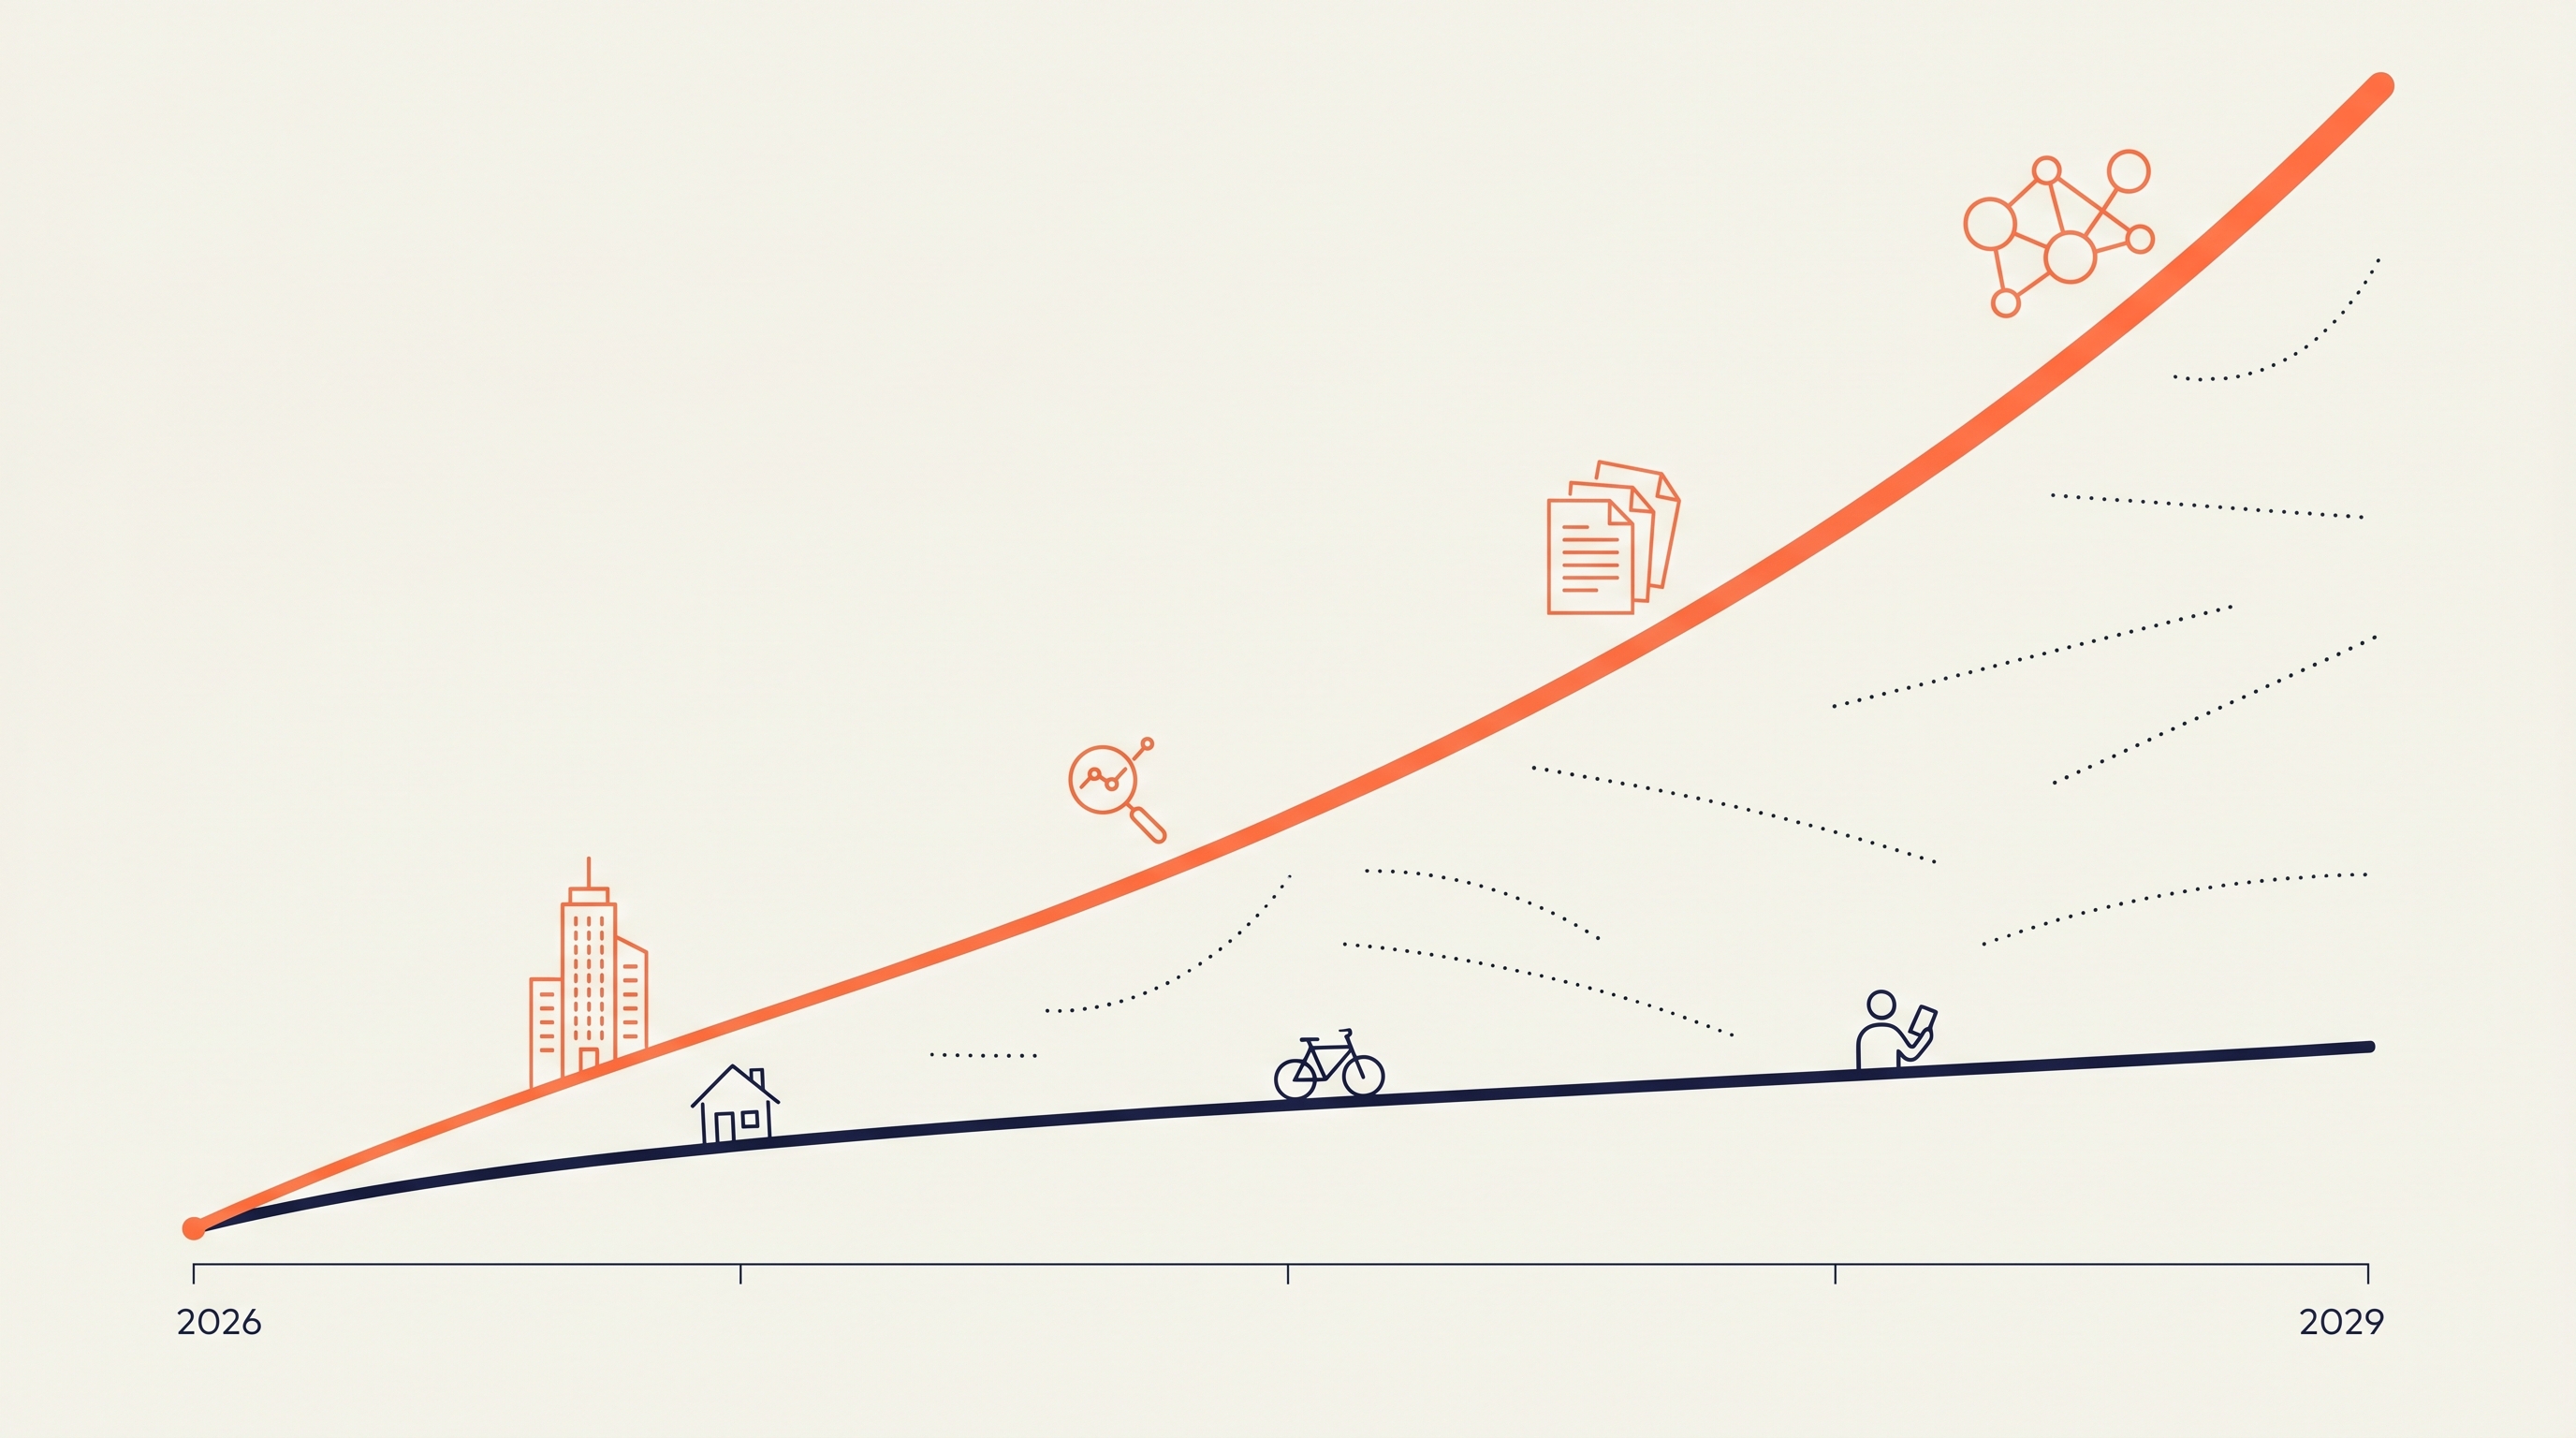
레이 커즈와일은 2029년에 기계가 인간 수준의 지능에 도달하고, 2045년에 인간의 지능이 비생물학적 형태로 확장된다고 예측했다. 황당하게 들릴 수 있지만 그의 35년치 예측 적중률은 86%다. 1970년대에 "1995년 컴퓨터가 체스 챔피언을 꺾는다"고 했고, 그대로 됐다.
이 86%라는 숫자가 사람들 마음을 흔드는 이유는 두 가지다. 하나는 "생각보다 빨리 올지 모른다"는 기대. 다른 하나는 "그 변화가 모두에게 동시에 오리라"는 가정이다. 커즈와일 자신이 그 가정을 거든다 — 휴대폰이 억만장자의 전유물에서 10년 만에 80억 명의 손에 쥐어진 것처럼, AI도 결국 모두에게 닿는다고.
나는 이 두 번째 가정에 동의하지 않는다. 그리고 동의하지 않는 이유는 비관주의가 아니다. 특이점이 모두에게 오지 않는 것은 어떤 잘못이나 결함 때문이 아니라, 그 시스템이 원래 그렇게 작동하기 때문이다. 격차는 우연이 아니라 기본값이다. 그 기본값을 바꾸지 않으면, 86%의 적중률을 가진 예측이 맞을수록, 격차도 같은 정밀도로 벌어진다.
휴대폰 비유가 틀린 자리
커즈와일이 든 휴대폰 비유는 한 지점에서 멈춘다. 휴대폰은 손에 쥐어주는 것이 사용의 거의 전부였다. 전화 걸기, 문자 보내기, 사진 찍기. 사용 문턱이 낮았다. 그래서 보급률이 사용률에 가까웠다.
AI는 다르다. AI는 손에 쥐어주는 것은 시작일 뿐이고, 거기서부터 진짜 사용이 시작된다. 어떻게 질문할지를 배우고, 답을 어떻게 검증할지를 익히고, 자기 일에 어떻게 끼워 맞출지를 시간 들여 만든다. 사용 문턱이 보급 문턱보다 훨씬 높다. 보급률이 100%가 되어도 사용률이 50%에 못 미칠 수 있다. 이게 휴대폰과 AI의 가장 결정적인 차이다.
이 차이를 사람들은 잘 안 느낀다. 자기 옆 사람이 ChatGPT를 자기처럼 쉽게 쓴다고 가정하기 때문이다. 그러나 같은 도구를 쥐고도 누군가는 거기서 변호사 한 명 분의 일을 끌어내고, 누군가는 검색창 대용으로만 쓰다 그만둔다. 두 사람이 같은 도구를 쓰는 게 아니다. 같은 외형의 다른 도구를 쓰는 것이다.
격차는 한 차원이 아니라 세 차원의 곱셈이다
여기서 한 발 더 나가야 한다. 격차가 한 차원에서만 일어나는 게 아니라 자본·언어·인지 세 차원에서 동시에 곱셈으로 일어난다. 어느 하나가 0에 가까우면 곱은 0이 된다. 세 축이 다 0보다 크고 클수록, 곱은 기하급수적으로 커진다.
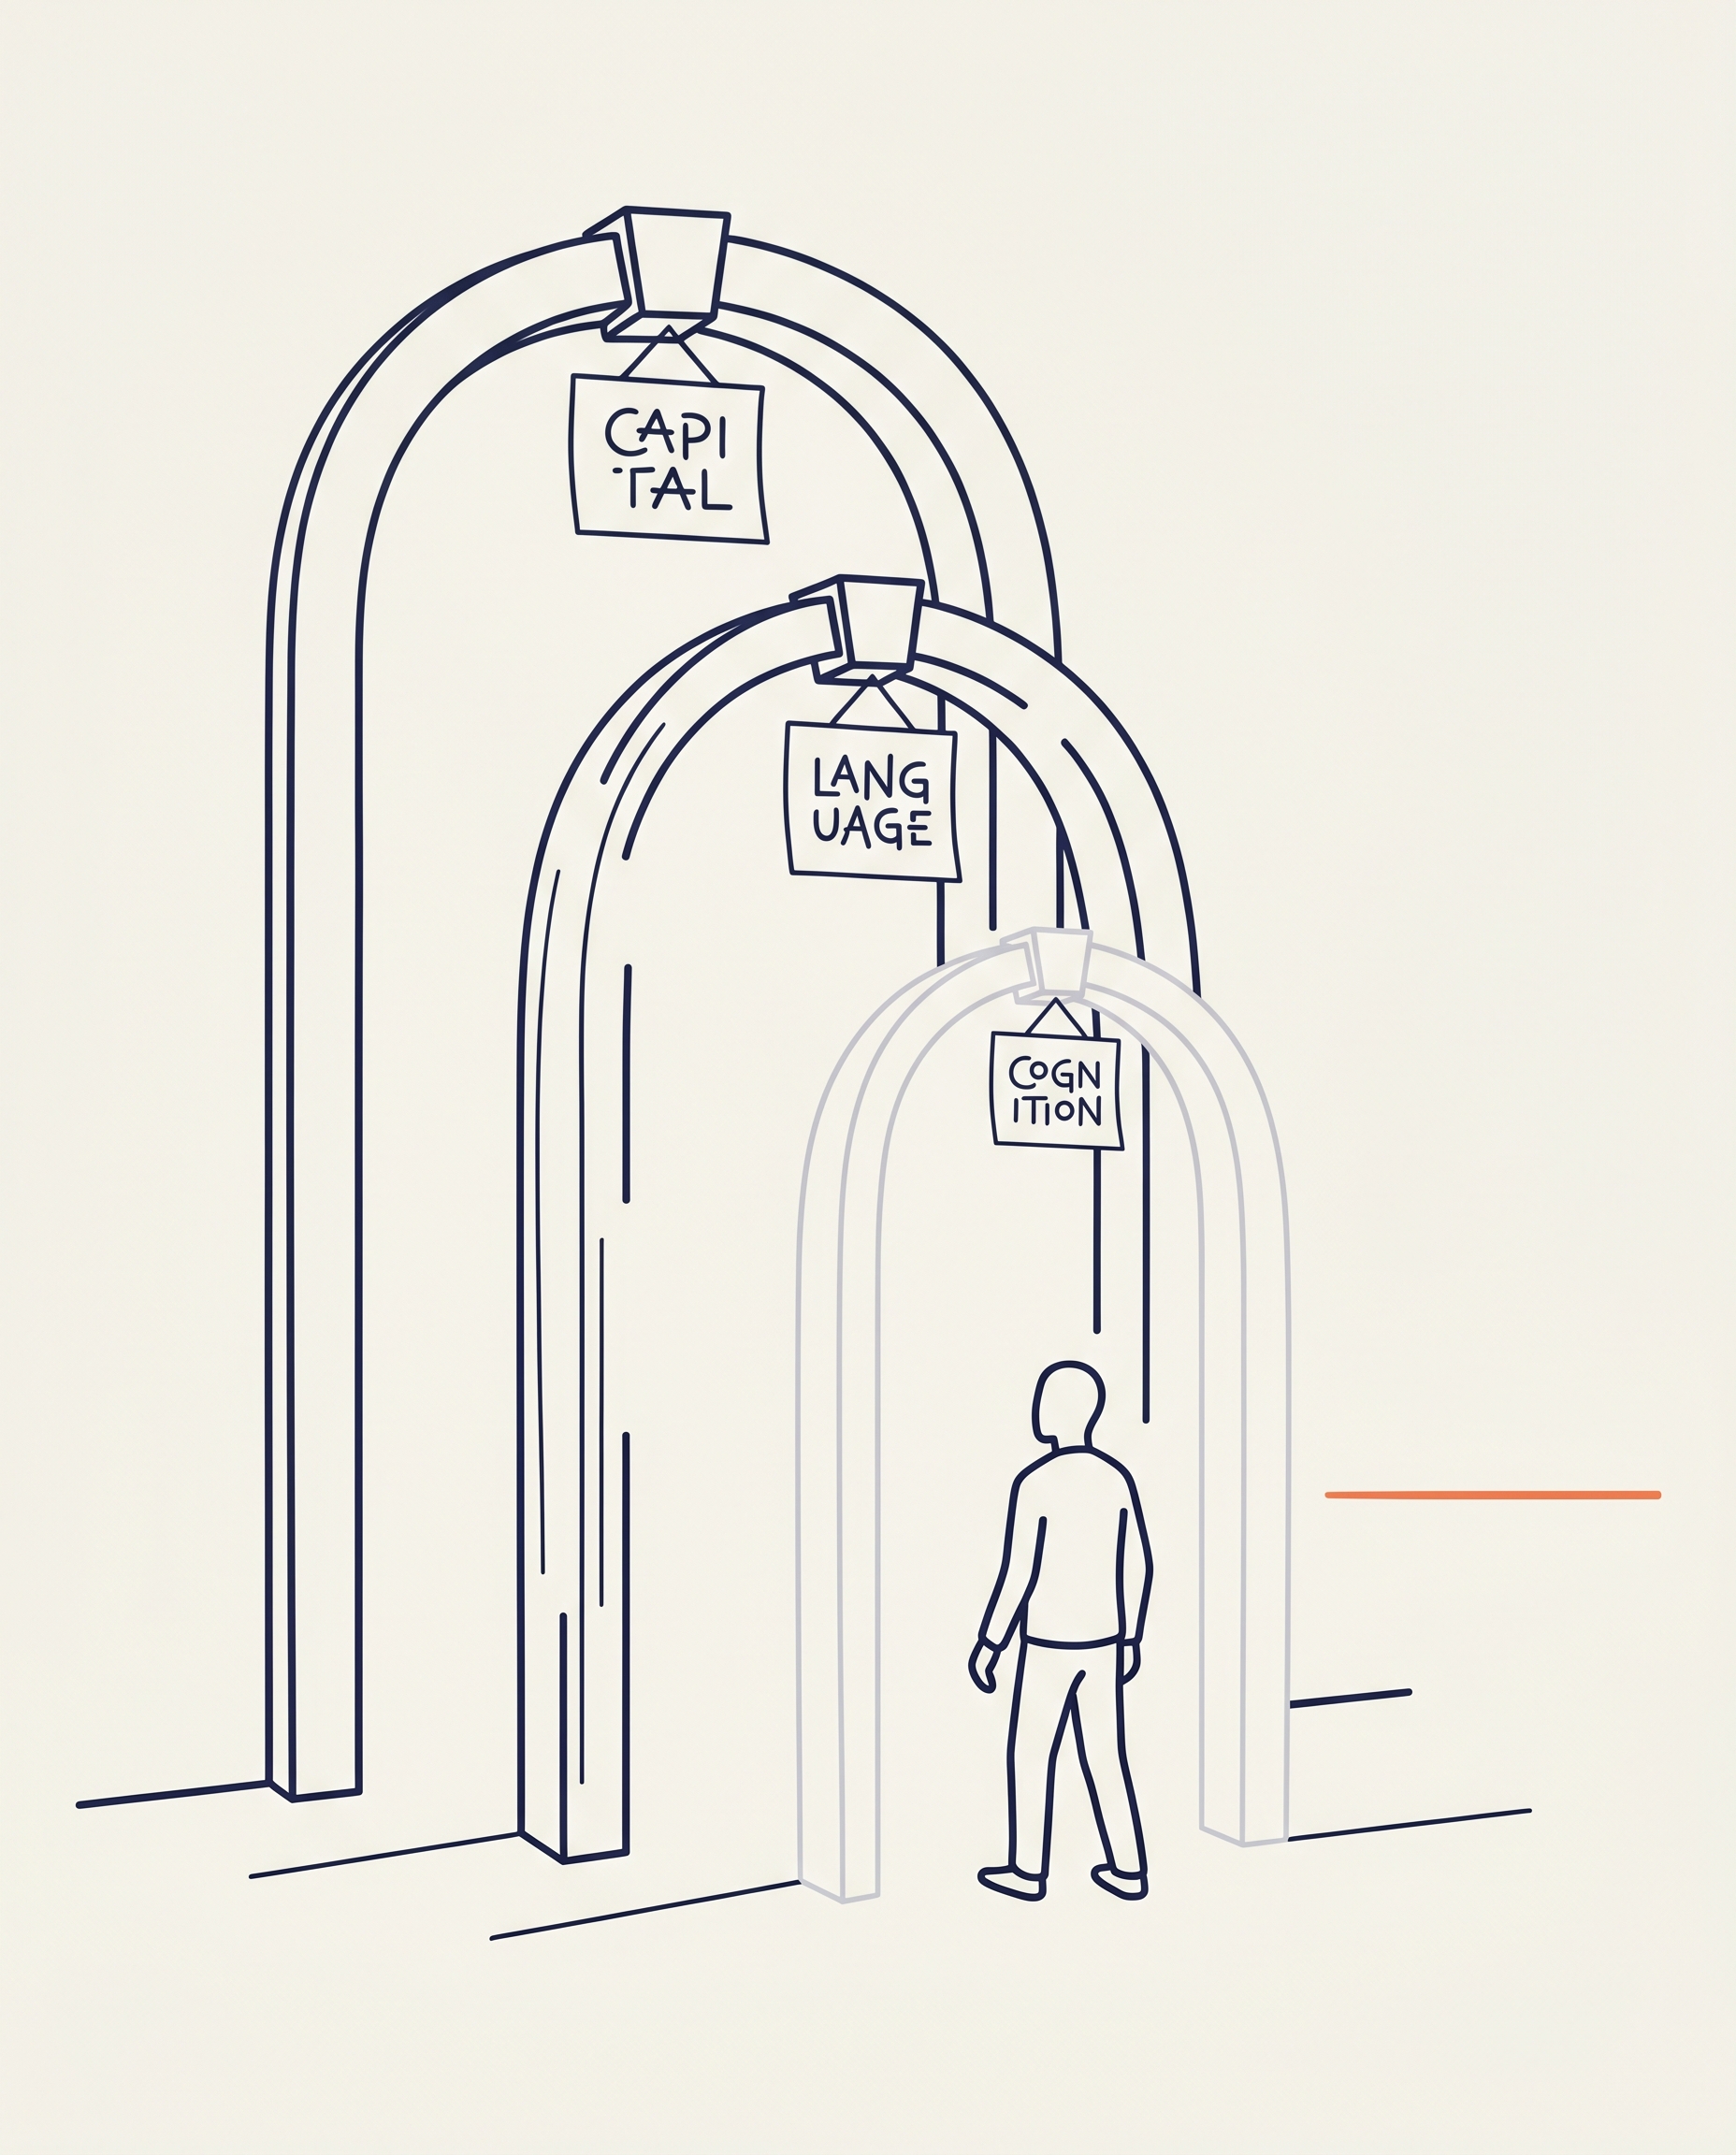
자본의 축. 첨단 모델을 쓰려면 유료 구독이 필요하다. 좋은 결과는 좋은 모델에서 더 자주 나온다. 기업 시장은 더 분명하다 — API 사용량, 자체 인프라, 데이터 파이프라인, 보안 인증, 컨설팅. 멕시코에서는 부유층 5분위가 빈곤층 5분위보다 GenAI를 활용한 일자리를 가질 확률이 5.6배 높다(IDB·세계은행 데이터). 라틴아메리카·카리브해 전역에서 약 1,700만 개의 일자리가 이론적으로는 GenAI의 혜택을 받을 수 있지만, 그 사람들에게는 컴퓨터·인터넷·기본 디지털 도구 자체가 없다. 시장은 이미 가진 사람을 더 잘 보조한다.
언어의 축. 대형 언어 모델은 영어와 중국어에서 가장 잘 작동한다. 한국어는 학계 분류로 "저자원 언어(low-resource language)"에 속한다(arXiv 2506.21595, "Thunder-LLM"). 같은 모델이라도 영어 질문에 대한 정답 회수율과 한국어 질문에 대한 정답 회수율 사이에는 측정 가능한 차이가 있다. 한 연구는 다국어 모델에서 거짓 응답을 줄이는 학습(unlearning)을 했을 때, 영어에서는 거짓이 63% 줄었지만 저자원 언어에서는 줄어드는 폭이 훨씬 작거나, 일부에서는 오히려 거짓이 늘었다고 보고했다. 언어 자체가 격차의 한 축이다. 그리고 한국어 안에서도 표준어와 농촌 사투리, 노년층의 어법, 특정 도메인의 전문 용어 사이에 또 다른 층이 있다. 격차는 안으로 들어갈수록 더 정밀해진다.
인지의 축. 한국지능정보사회진흥원(NIA)이 발표한 2024년 디지털정보격차 실태조사에 따르면, 고령층의 디지털 정보화 수준은 71.4%, 농어민은 80.0%다. 1년 전보다 각각 0.7%p, 0.5%p 개선됐지만, 일반 국민 대비 격차는 여전히 크다. 그리고 디지털 정보화 수준은 "기기를 갖고 있고, 기본 인터넷을 쓸 수 있다"는 의미다. AI를 쓸 수 있는지는 다른 문제다. 그 다음 차원의 측정은 아직 표준화되지도 않았다.
이 세 축은 독립적으로 더해지는 게 아니라 서로를 곱한다. 농촌의 70대 한국어 사용자가 무료 AI 도구로 자기 일에 도움을 받기까지 넘어야 하는 거리는, 도시의 30대 영어·한국어 이중 사용자가 유료 AI 도구로 같은 일을 하는 거리보다 단순히 "조금 더" 먼 게 아니다. 세 축의 곱이 곱해진 만큼 멀다.
AI precariat — 새 계급의 이름
세계경제포럼(WEF)이 2025년부터 2026년 초까지 반복해서 다룬 개념이 있다. AI precariat — AI 시대의 불안정 계급. 영국 경제학자 가이 스탠딩이 2011년에 만든 'precariat'(불안정 노동자) 개념의 AI 버전이다.
원래의 precariat은 "불안정·배제·불안"으로 정의되는 계급이었다. AI precariat은 거기에 새 차원을 더한다. 직업 상실의 슬픔, 사회로부터의 소외, 그리고 시민적 신뢰 자체의 붕괴. 단순히 일자리가 없어서가 아니다. 자기 분야가 통째로 무너지는 경험을 5년 안에 두 번 겪고, 그 사이에 사회가 "당신이 뒤처졌다"고 말하는 구조다.
WEF 2026 〈Global Risks Report〉는 이 흐름의 더 큰 그림을 그렸다. 비즈니스와 경제 권력이 새로운 극단으로 집중되면서, 사회 안에서도, 국가 사이에서도 디지털 격차가 더 벌어질 수 있다는 것. 이게 의미하는 바는 명확하다. 격차는 자연스럽게 좁혀지지 않는다. 오히려 시장의 자연 상태에서는 벌어진다.
시장의 기본값은 격차다
이 지점이 가장 받아들이기 힘든 부분이다. 우리는 기술이 결국 보편화된다는 서사에 익숙하다. 자동차도, 전기도, 인터넷도, 휴대폰도 그랬으니까. 그런데 그 보편화는 가만히 일어난 게 아니다. 공공 인프라 투자, 보편 서비스 의무, 보조금, 교육 의무가 그 보편화를 만들었다. 시장 혼자서 한 게 아니다.
브루킹스연구소가 2024년 분석한 미국 데이터는 이 점을 다시 확인해 준다. 도시·해안 지역의 ChatGPT 채택률이 농촌·남부·애팔래치아·중서부보다 현저히 높다. 마이크로소프트의 자체 연구도 같은 결과를 보고했다. 같은 나라, 같은 언어, 같은 시간 안에서도 격차가 벌어졌다. 누가 그 격차를 막아 줄까? 시장은 아니다. 시장은 격차가 있을수록 더 많은 광고와 유료 등급을 만들어낼 뿐이다.
영양군에서 본다면 그림이 더 선명해진다. 인구 1만 6천 명, 고령화율 45%, Google Trends에서 AI 검색량이 측정 한계 아래에 있는 곳. 시장의 자연 상태에 맡기면 영양군은 특이점의 혜택이 도달하는 마지막 줄에 들어간다. 그것도 5년 뒤가 아니라, 충분히 도시에서 다 누린 뒤다. 사실 영양군은 마지막 줄에도 못 들 가능성이 더 높다.
모세혈관의 일
그럼 어떻게 해야 하나. 거대한 정책 한 방으로 격차가 좁혀지지 않는 것을 우리는 이미 안다. 격차가 자본·언어·인지의 곱으로 벌어진다면, 좁히는 일도 그 세 축에서 동시에 일어나야 한다.
자본의 축에서는 공공이 먼저 움직이는 무료 도구·교육·인프라가 필요하다. 무상 보급의 영역. 이건 시장이 안 한다.
언어의 축에서는 한국어, 그리고 한국어 안의 다양한 층(노년 어법, 농촌 화법, 도메인 용어)을 모델 옆에 깔아 주는 작업이 필요하다. 작은 RAG, 작은 온톨로지, 자기 동네에서 자기 말로 답하는 AI를 만드는 일. 이건 정부도 잘 못 한다. 지역의 작은 단위가 해야 한다.
인지의 축에서는 매주 같은 장소에서 같은 사람이 옆에 앉아 "이거 한 번 눌러보세요"라고 말하는 일이 필요하다. 70대 손가락이 처음 ChatGPT를 여는 그 30분. 이건 어떤 알고리즘도, 어떤 정부 사업도 대신 해주지 못한다.
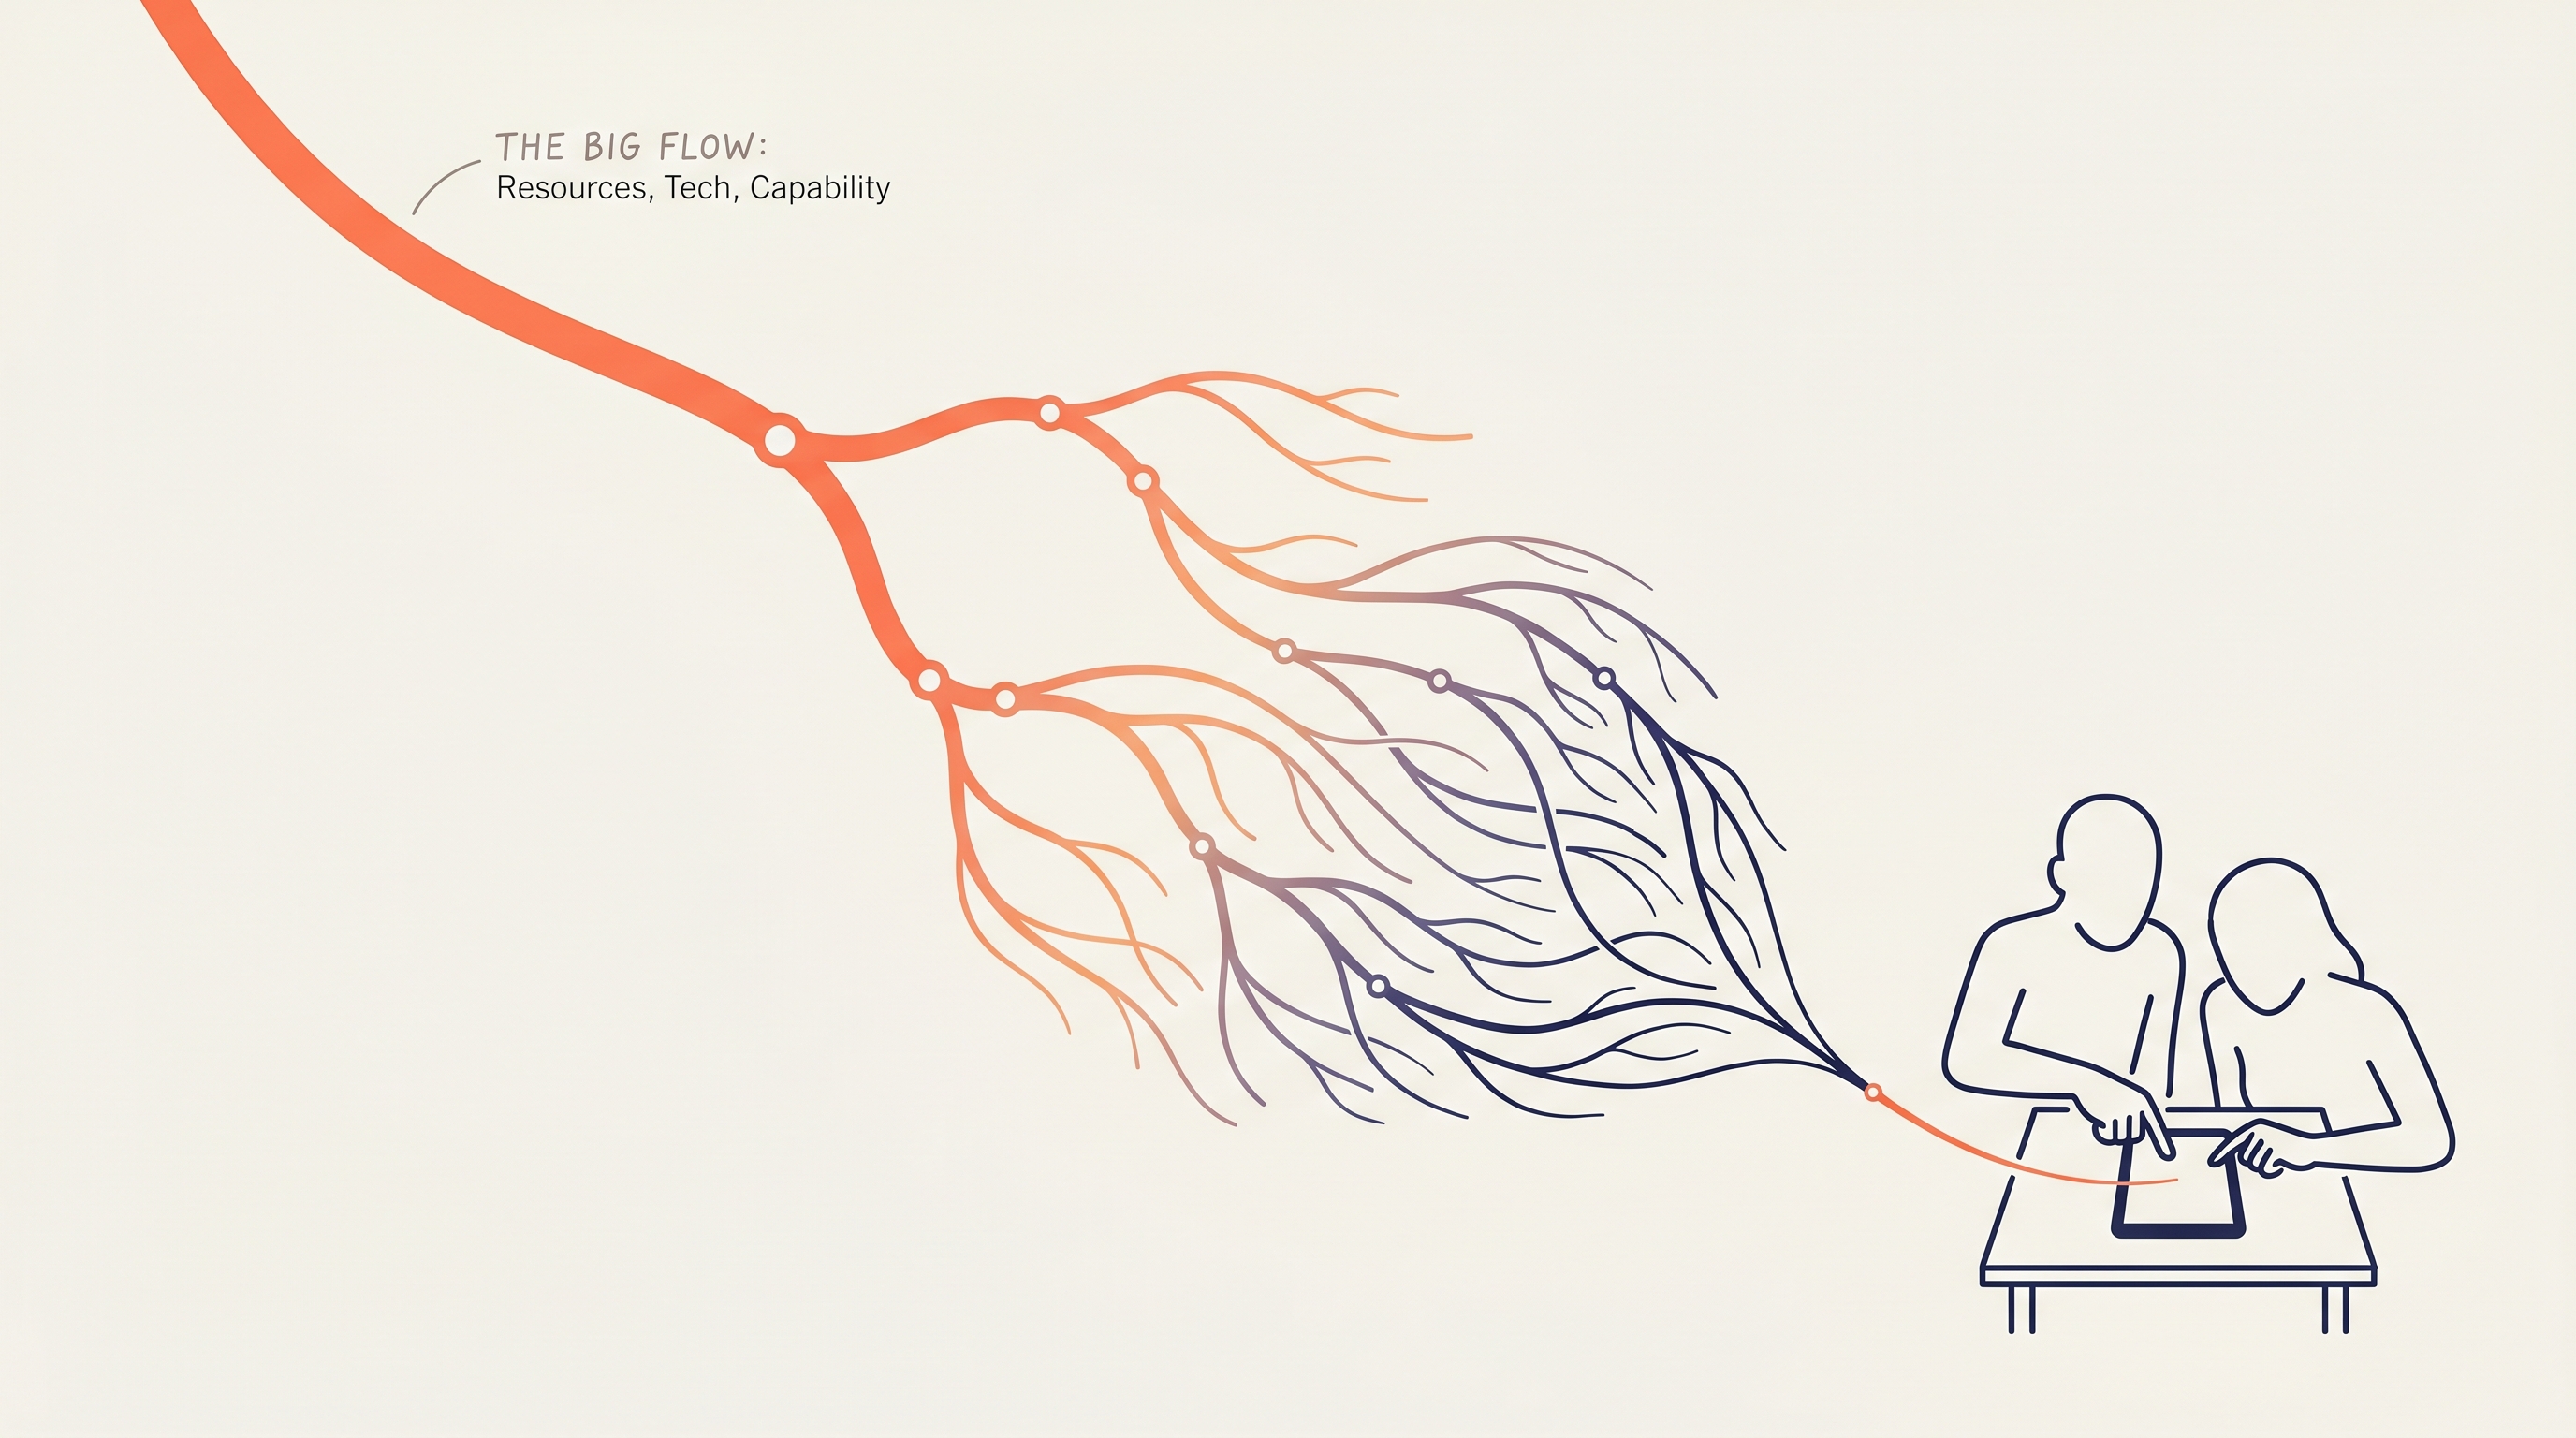
이게 모세혈관의 일이다. 동맥과 정맥 사이를 잇는 가장 가는 혈관. 도시의 큰 흐름과 시골의 작은 호흡을 잇는 일. 시장의 기본값으로는 이 모세혈관이 만들어지지 않는다. 그것은 의지의 산물이다. 누군가가 "여기서, 이 사람들과, 이 시간에" 직접 손을 대야 만들어진다.
결론 — 86%의 적중률 앞에서
커즈와일의 86%가 두려운 이유는, 만약 그가 맞다면 우리에게 남은 시간이 많지 않다는 것이다. 2029년이면 4년 남았다. 그 4년 안에 도시 사용자가 AI와 함께 법률 자문, 의료 진단, 비즈니스 전략을 처리하는 동안, AI 검색량이 0점인 한 군이 어디까지 닿느냐가 결정된다.
이 글의 결론은 "지금 시작하면 늦지 않는다"는 익숙한 말이 아니다. 더 정직하게 말하면, 시장의 기본값에 맡기면 무조건 늦는다. 늦지 않으려면 모세혈관이 되는 누군가가 있어야 한다. 그 누군가가 자본의 격차, 언어의 격차, 인지의 격차를 동시에 줄이는 작은 손길을 매주 반복해야 한다.
영양군AI협회는 그 모세혈관이 되려 한다. 우리만이 할 수 있는 일이라서가 아니라, 우리가 안 하면 우리 동네에서는 아무도 안 하기 때문이다. 시장은 영양군을 마지막 줄에 두고, 정부는 평균을 본다. 평균은 맞을지 모르지만, 영양군의 70대에게 평균은 의미가 없다.
특이점은 모두에게 오지 않는다. 그러나 그건 어쩔 수 없는 운명이 아니다. 그것은 우리가 지금 무엇을 하느냐에 따라 바뀌는, 우리 손에 일부분 달려 있는 결과다. 86%의 적중률을 가진 사람의 예측이 맞다면, 우리는 그만큼 빠르게 움직여야 한다. 느린 손길로, 그러나 매주 같은 자리에서.
참고 문헌:
- Ray Kurzweil — The Singularity Is Nearer (2024). 35년 예측 적중률 86%, 2029년 AGI / 2045년 특이점 예측
- World Economic Forum — The Overlooked Global Risk of the AI Precariat (2025)
- World Economic Forum — Global Risks Report 2026, Chapter 2
- World Economic Forum — How the Global South Is Reimagining the Future of AI (2026)
- arXiv 2506.21595 — Thunder-LLM: Efficiently Adapting LLMs to Korean with Minimal Resources (한국어가 저자원 언어임을 확인)
- arXiv 2406.13748 — Every Language Counts: Learn and Unlearn in Multilingual LLMs (영어 -63% vs 저자원 언어 격차)
- 과학기술정보통신부 / NIA — 2024년 디지털정보격차 실태조사 (고령층 71.4%, 농어민 80.0%)
- Brookings — Why AI Readiness Requires Digital Literacy and Inclusion / AI Transforming Middle-Class Jobs, Can It Help the Poor?
- Microsoft Research — ChatGPT 지역별 채택률 분석 (해안 도시 vs 남부·애팔래치아·중서부)
- Stanford — Generative AI for Health in Low & Middle Income Countries
- Guy Standing — The Precariat: The New Dangerous Class (2011), AI 버전 확장
이 글은 명성심재의 심층 사고 엔진
Simthink Engine (深 Think)으로 작성되었습니다.